长期以来,深度神经网络被视为一种“黑箱”:我们知道它能够完成预测、分类和推理,却难以解释其内部究竟如何组织信息。
近年来,一系列研究发现了一个令人惊讶的现象:神经网络学习到的高维内部表示,并不是完全杂乱无章的数值,而可能呈现圆环、螺旋、环面、正多面体等具有明确数学意义的几何结构。
例如,语言模型在表示星期和月份时形成圆环;学习数学运算的Transformer出现周期性几何结构;核质量预测模型中,质子数和中子数的嵌入向量甚至形成了类似DNA的双螺旋。
这些发现正在推动一个重要研究方向的发展:神经网络表征几何学(Geometry of Neural Representations)。
其核心目标是通过研究神经网络内部信息的几何组织方式,进一步理解模型学到了什么、如何计算,以及为什么能够泛化。

一、神经网络内部为什么存在“几何空间”?
神经网络处理信息时,通常需要将输入转换为高维向量。
例如,一个词语可以被表示为数百维甚至数千维的向量;一幅图像经过神经网络处理后,也会形成一个高维特征向量。
这些向量所在的空间,通常被称为表征空间(Representation Space)。在涉及内部隐藏变量或嵌入时,也经常使用潜在空间(Latent Space)这一术语。
虽然人类无法直接观察几百维、几千维空间,但这些向量之间仍然存在距离、方向、角度和其他数学关系。
如果某些对象具有相似属性,它们在表征空间中可能相互接近;如果对象之间存在周期性、层次性或对称性,其内部表示也可能形成相应的几何结构。
例如,星期一至星期日是一组周期性概念。假如使用一条直线依次表示七天,那么星期日和星期一就会距离很远,这与实际的周期关系不符。
如果将七天排列在一个圆环上,星期日和星期一便自然相邻。一个星期对应旋转一周,日期推进对应沿圆周移动。
圆环因此可能成为神经网络编码周期性信息的一种高效方式。
类似地,如果信息同时具有两个独立的周期变量,就可能出现环面;如果涉及多个类别之间的均衡分离,则可能出现规则多面体结构。
这些结构不一定由研究人员事先设计,而可能在模型训练过程中自行形成。
二、如何从高维潜在空间发现几何结构?
最常用的方法之一是主成分分析(Principal Component Analysis,PCA)。
PCA的基本原理,是在高维数据中寻找变化最显著的几个方向,将数据投影到二维或三维空间,从而观察其主要结构。
假设一个神经网络使用1024维向量表示某类信息。研究人员可以收集大量这样的向量,利用PCA提取前三个主成分,再将其绘制成三维散点图。
原本无法观察的高维分布,就可能呈现圆环、螺旋或其他结构。
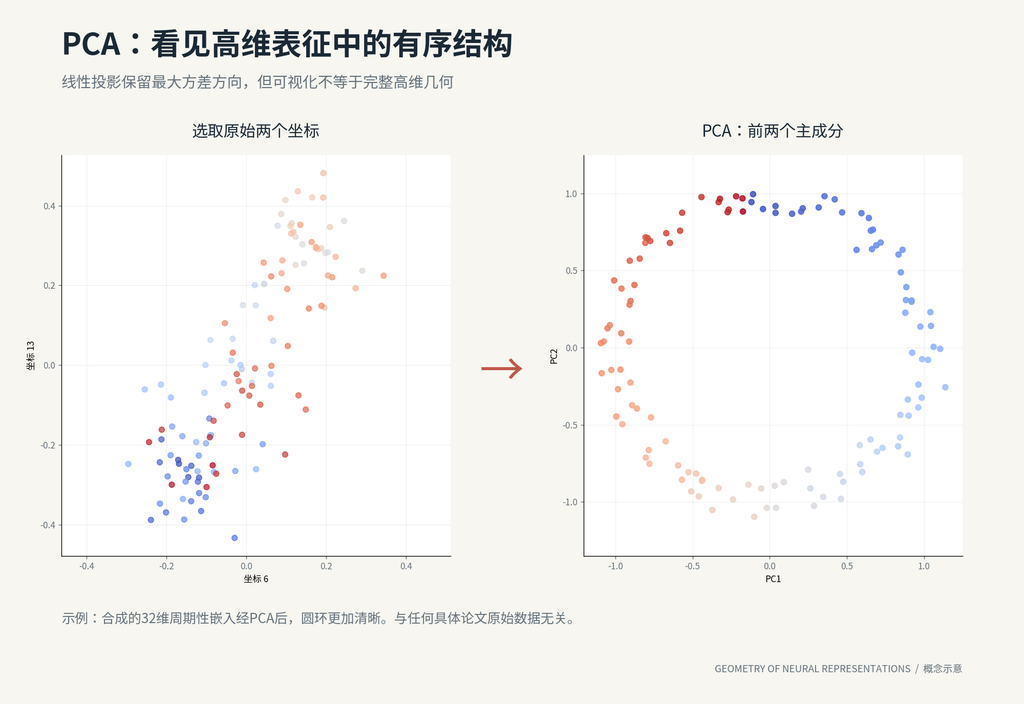
PCA的优势在于,它采用线性投影,主成分具有明确的统计意义,并且可以计算各个主成分保留的数据方差比例。
但PCA也有局限:高维空间中的复杂非线性结构,不一定能够通过三维线性投影完整呈现。
因此,研究人员还会使用UMAP、t-SNE等非线性降维方法,以及流形学习、拓扑数据分析等技术。
这里涉及两个重要概念。
几何(Geometry)主要研究距离、角度、曲率等性质;拓扑(Topology)则更关注结构是否连通、具有多少个孔洞等不易因连续变形而改变的性质。
例如,一个圆环无论被拉长还是压扁,只要没有断裂,其闭合循环的拓扑性质仍然存在。
因此,现代神经网络表征几何学研究已经不满足于绘制漂亮的散点图,而是进一步研究这些图形背后的几何与拓扑规律。
三、案例一:核质量预测模型中的“双螺旋”
2026年10月,发表于《Communications AI & Computing》的论文《Interpretable AI reveals hidden structure in nuclear masses》,为这一研究方向提供了一个非常直观的案例。
研究人员训练神经网络,根据原子核的质子数Z和中子数N预测核结合能。
模型分别学习质子数和中子数的高维嵌入向量。
随后,研究人员对这些嵌入进行PCA分析,发现前三个主要成分构成了类似DNA的双螺旋结构。
其中,两条螺旋分别对应质子数和中子数的表示,连接关系则与不同同位素链中最稳定的原子核有关。
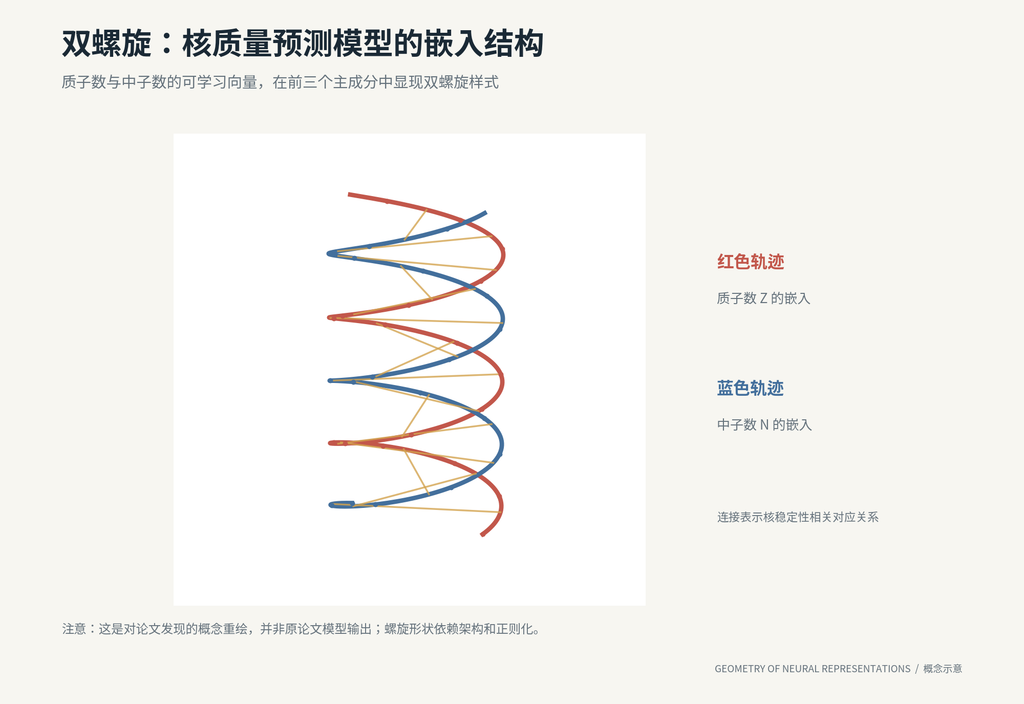
更重要的是,研究人员进一步分析了模型为什么形成这样的表示。
第一主成分主要编码质子数或中子数的大小,而其他主成分参与表达质子与中子之间的不对称关系。
这些关系与传统核物理中描述结合能的理论项存在明确联系。
研究还发现,模型对核结合能的预测可以分解成具有物理意义的层次结构,其中包含经典液滴模型的主要规律,以及与核壳层等效应有关的修正项。
因此,双螺旋并不只是一个视觉上吸引人的结果,而成为研究人员解释模型内部计算机制的线索。
不过需要强调:双螺旋不是原子核自身的物理形状,而是特定神经网络架构及正则化条件下形成的嵌入结构。
论文表明,在其研究的正则化模型范围内,这种几何形态具有一定稳健性;但去除正则化后,也可能得到预测效果相近、却不再具有相同螺旋形态的表示。
这说明神经网络表征几何既受到任务规律影响,也受到模型架构和训练方式影响。
四、案例二:数学运算网络中的“圆环”
另一个经典案例来自Grokking研究。
Grokking通常指一种特殊的学习现象:神经网络先记住训练数据,在训练相当长时间后,测试集表现才突然显著改善。
2022年的研究《Towards Understanding Grokking: An Effective Theory of Representation Learning》分析了神经网络学习数学运算时的内部表示。
研究人员发现,当Transformer学习模加法时,其数字嵌入向量经过PCA投影后,可以从相对混乱的分布逐渐形成有序的圆环。
所谓模加法,可以理解为时钟上的运算。
例如,时钟只有12个刻度,数字11加3并不会得到14,而是回到2。
这样的计算天然具有周期性。
在几何上,模加法可以通过圆环上的旋转来表示。
随后,2023年的《Progress measures for grokking via mechanistic interpretability》进一步分析了相关Transformer的内部机制,发现网络能够利用离散傅里叶变换及三角函数关系,将模加法转化为周期性计算。
研究人员还通过权重分析、激活分析和消融实验验证相关机制。
这类研究说明:
神经网络的泛化能力,可能与其是否学习到适合任务的内部数学表示密切相关。
模型不再只是记忆大量输入和输出之间的对应关系,而是逐渐形成能够重复使用的计算规则。
五、案例三:大语言模型中的“星期圆环”和“月份圆环”
2025年ICLR论文《Not All Language Model Features Are One-Dimensionally Linear》,将类似研究扩展到了大语言模型。
过去,一些可解释性研究倾向于将模型内部的某个概念对应到一个特征方向。
例如,一个方向可能与某类语义特征相关。
但是,该研究提出:有些特征本质上可能是多维结构,而不是单一方向。
研究人员利用稀疏自编码器(SAE)分析GPT-2和Mistral 7B,发现了与星期、月份有关的环形表示。
例如,星期一至星期日不是简单排列在一条直线上,而是可以在二维子空间中形成有序圆环。
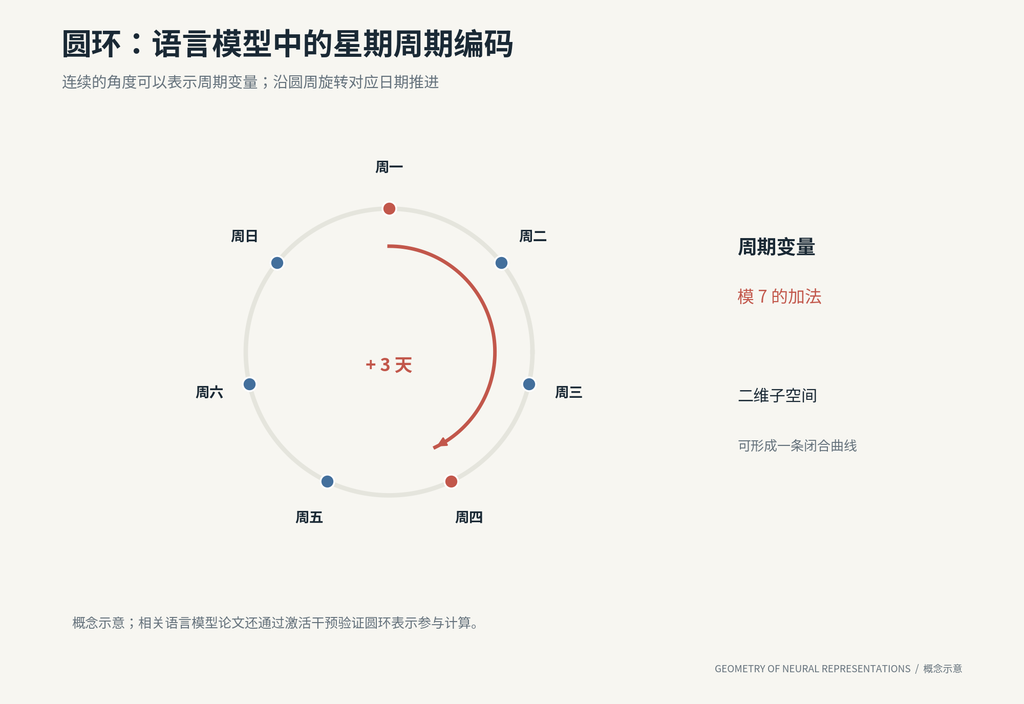
更有意义的是,这些结构并非只能用于展示。
研究人员设计日期推理任务,并通过激活替换等干预方法发现,相关环形表示确实参与了模型的日期计算。
这提供了比单纯观察PCA散点图更强的证据。
它还说明,某些概念可能需要多个神经元或多个特征方向协同表示。
理解一个概念,不能始终局限于寻找一个对应的神经元或一条特征轴。
六、案例四:语言模型中的颜色流形与位置螺旋
2025年的论文《The Origins of Representation Manifolds in Large Language Models》,从更一般的角度研究了语言模型中的表征流形。
所谓流形(Manifold),可以通俗理解为嵌入高维空间中的低维连续结构。
例如,圆周虽然处于二维平面中,却只需要一个角度变量就能描述;球面位于三维空间中,却只需要两个参数来确定位置。
这类研究提出,神经网络对于连续变化概念的表示,也可能具有类似的低维几何性质。
研究人员分析语言嵌入和模型激活,观察到颜色、时间等概念存在有组织的几何关系,并从理论上讨论了表示空间中的相似度如何反映概念的内在几何。
例如,颜色之间存在连续变化关系,其表示自然可能更接近一条弯曲的轨迹或一个流形,而不是完全独立的离散点。
另一个相关研究《Visualizing LLM Latent Space Geometry Through Dimensionality Reduction》则分析了GPT-2和LLaMA的内部状态。
研究人员通过PCA和UMAP等方法,观察到模型的位置嵌入具有高维螺旋式结构,并展示了不同网络层内部状态的几何变化。
这种螺旋与核质量模型的双螺旋含义不同。
前者主要关联序列位置的编码方式,后者则关联核物理变量之间的关系。
不过,该位置螺旋研究仍属于相对早期的探索性分析,其几何发现不能直接等同于已经完整识别出模型的计算机制。
七、案例五:分类神经网络中的“正单纯形”
几何结构并不局限于圆环或螺旋。
2020年发表在PNAS的论文《Prevalence of neural collapse during the terminal phase of deep learning training》,提出了著名的神经塌缩(Neural Collapse)现象。
研究人员发现,在某些分类网络训练后期,同一类别的特征向量会越来越接近其类别中心。
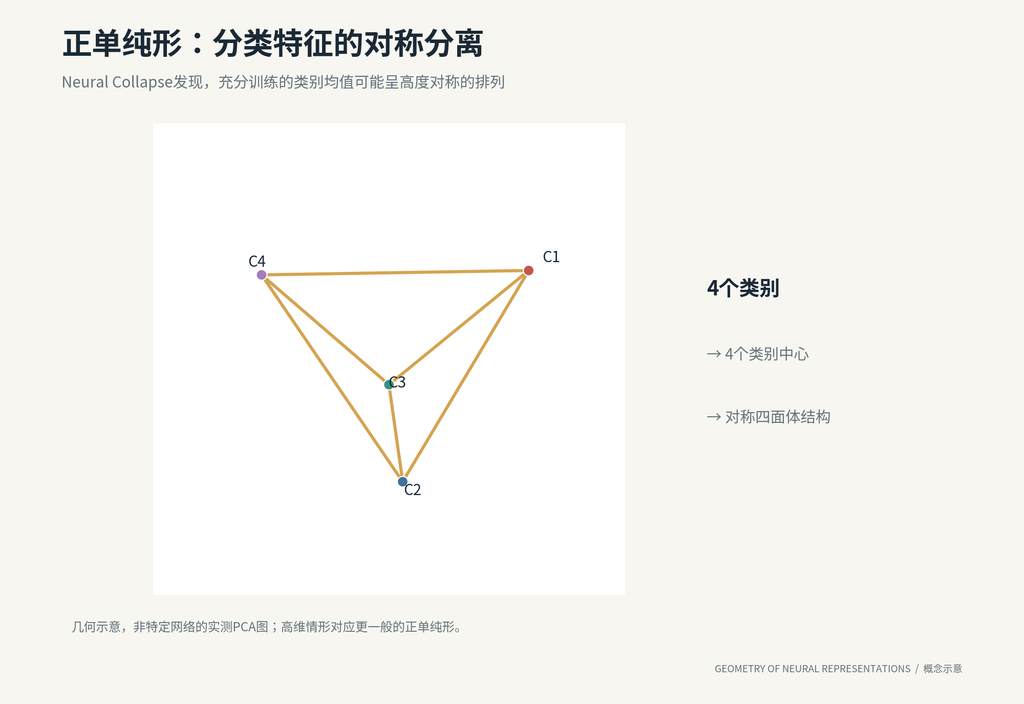
与此同时,不同类别的中心逐渐形成高度对称的几何排列。
这种结构被称为正单纯形等角紧框架(Simplex Equiangular Tight Frame)。
通俗理解,如果有三个类别,其中心可以排列成等边三角形;如果有四个类别,则可以排列成正四面体。
随着类别数量增加,这种结构可以推广到更高维空间。
为什么会出现这种现象?
从分类角度看,模型需要将不同类别有效区分开来。
当不同类别的中心形成对称且分离良好的排列时,可以实现一种均衡的类别区分方式。
神经塌缩研究说明,深度分类网络训练到一定阶段后,内部特征可能趋向高度规则的几何组织。
与圆环案例不同,这里的关键并不是周期性,而是类别分离与几何对称性之间的关系。
八、案例六:特征叠加与正多面体几何
2022年,Anthropic发表《Toy Models of Superposition》,研究神经网络如何在有限维度中表示比维度数量更多的特征。
一个神经网络内部可能存在大量需要编码的概念,但可供使用的神经元和表示维度始终有限。
研究发现,当特征足够稀疏时,模型可以通过特征叠加(Superposition),让不同特征共享部分表示方向。
这意味着,一个神经元不一定只对应一个概念。
在简化模型中,研究人员发现特征方向可能形成与正多面体相关的几何排列。
这种排列反映了网络如何在有限维度中同时容纳多个特征,并尽量控制特征之间的干扰。
这项研究的重要性在于,它把神经网络的可解释性问题与几何优化联系起来。
内部几何结构不仅可能来自输入数据的规律,也可能来自神经网络对有限表示资源的高效利用。
不过,这些结论最初来自可控的简化模型,不能直接推断所有大型神经网络都会形成相同的正多面体结构。
九、案例七:空间导航网络与大脑中的“环面”
神经网络表征几何学还有一个重要的相关研究来源:计算神经科学。
2022年《Cell Reports》论文《Excitatory-inhibitory recurrent dynamics produce robust visual grids and stable attractors》,研究了用于空间导航的兴奋性—抑制性循环神经网络。
研究人员发现,模型在学习导航任务后,其神经群体活动可以形成环状或环面状的低维吸引子结构。
所谓吸引子(Attractor),是指动态系统倾向于维持或返回的一组稳定状态。
这种结构与模型如何持续表示空间位置,以及如何在运动过程中更新内部状态有关。
更有代表性的是2022年《Nature》论文《Toroidal topology of population activity in grid cells》。
研究人员记录大量真实网格细胞的活动,并使用PCA、UMAP以及拓扑数据分析,发现这些神经元的群体活动位于具有环面拓扑的流形上。
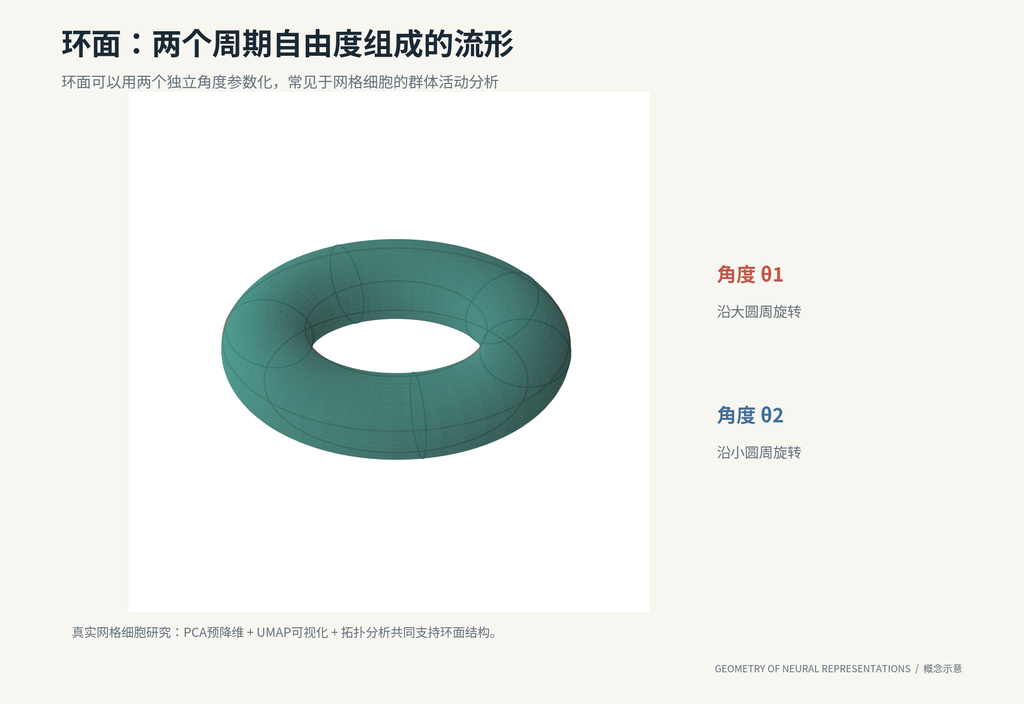
这里的研究对象是真实动物神经系统,而不是人工神经网络。
值得注意的是,该论文首先通过PCA将活动数据降到六维,再使用UMAP进行三维可视化,并利用拓扑分析支持环面结构的判断。
因此,不能简单地将其描述为“PCA直接发现三维环面”。
这项研究具有特殊意义:人工神经网络和真实生物神经系统,都可能通过低维几何结构组织复杂的动态信息。
它为人工神经网络可解释性、计算神经科学与几何学之间建立了联系。
十、从观察形状走向理解计算机制
上述研究呈现出一个共同趋势:神经网络的内部表示可能具有明显的几何组织方式。
不同形状也可能对应不同的信息组织需求。
圆环经常与周期性变量有关;螺旋可以组合顺序信息和周期变化;环面能够表示多个独立周期变量;正单纯形则可以反映类别之间的对称分离。
但是,这些对应关系并不是一套普遍适用的固定规则。
同一个任务可以存在多种有效表示,不同网络架构和训练方法也可能产生不同形状。
因此,研究人员必须回答三个层次的问题。
第一,几何结构是否真的存在?
研究人员需要检查PCA解释方差的比例,并使用不同降维方法、不同随机初始化和不同训练设置验证结果。
如果某种形状只有在特定可视化参数下才出现,就需要谨慎解释。
第二,几何结构是否与任务的数学规律有关?
例如,圆环是否真正编码周期性变量?螺旋的轴向与旋转方向是否对应某些可识别的物理量?
这通常需要结合线性探针、数学拟合、符号回归和动力系统分析。
第三,几何结构是否实际参与计算?
这是最关键的问题。
即使某个几何结构与模型预测高度相关,也不能立即认定模型依靠它完成计算。
更强的验证方法包括激活替换、子空间干预、特征消融等。
例如,改变模型内部圆环上的某个表示位置,观察它是否按照预期改变日期计算结果。
如果干预结果与数学假设一致,才能更有把握地认为发现了具有实际作用的计算机制。
由此,神经网络表征几何学正在从简单的“结构可视化”,走向“几何结构识别—数学规律提取—因果机制验证”的完整研究流程。
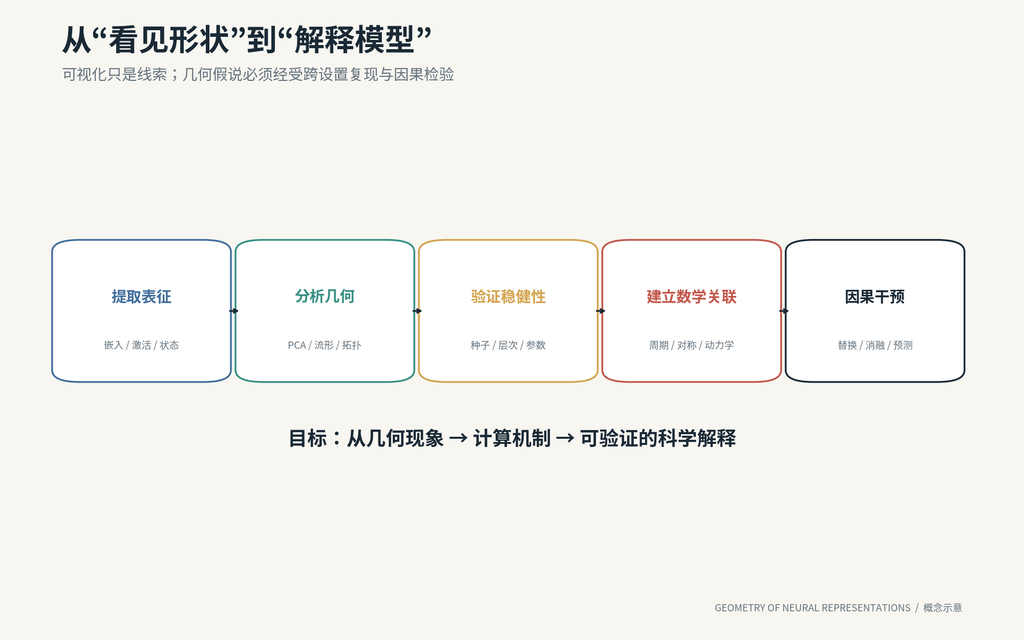
十一、研究方法正在从PCA扩展到流形与拓扑分析
除了PCA,相关研究已经发展出多种互补工具。
UMAP和t-SNE有助于观察复杂的非线性分布,但它们可能改变距离关系或产生视觉上的聚集效应,因此不适合仅凭图片判断真实拓扑。
拓扑数据分析(TDA)则关注连通性、环路和孔洞等性质。持续同调(Persistent Homology)可以进一步判断这些结构是否在不同距离尺度下稳定存在。
例如,对于一个疑似圆环的高维点云,持续同调可以帮助检验其是否确实存在稳定的一维环路。
此外,表征相似性分析(RSA)和中心化核对齐(CKA)可以比较不同神经网络或不同网络层的表示关系。
这些方法并不要求两个模型使用完全相同的内部坐标,而是尝试比较它们编码信息的整体关系。
2019年的CKA研究表明,不同初始化训练出的网络,其内部表示仍可能具有可识别的对应关系。
2024年的《The Platonic Representation Hypothesis》则进一步提出一个具有启发性的假说:随着模型规模和能力增加,不同架构、不同模态的模型可能逐渐学习到某些相似的世界表示。
这意味着,神经网络表征几何学的研究对象已经从单一模型内部,扩展到跨模型、跨模态乃至人工神经网络与生物神经系统之间的比较。
不过,“不同模型最终收敛到统一几何结构”仍然是一种研究假说,而非已经得到普遍证明的结论。
十二、是否所有神经网络都存在简单的低维几何结构?
答案是否定的。
虽然圆环、螺旋等结构容易理解,但并非所有神经网络内部表示都能够用简单形状描述。
2019年《Nature》论文《High-dimensional geometry of population responses in visual cortex》分析了真实视觉皮层神经元对自然图像的反应。
研究发现,神经群体活动具有复杂的高维统计结构,其主成分方差呈现特定的幂律衰减关系。
这说明,高维表示本身也可能具有重要的信息编码价值。
对于真实世界的复杂任务,神经网络可能同时存在低维和高维结构:某些特定概念位于简单的低维子空间,而整体表示仍然具有很高的有效维度。
此外,几何结构还存在坐标选择问题。
一个模型内部的表示可以经过某些可逆变换,而模型整体功能并不改变;但变换后的欧氏距离、角度和可视化形态可能发生变化。
因此,不能把某次降维所得的形状,直接视为模型内部唯一、客观且不变的几何形式。
真正重要的,是那些能够跨不同条件稳定存在,并与计算功能建立明确联系的结构性质。
十三、神经网络表征几何学对AI for Science的价值
对于AI for Science而言,神经网络表征几何学提供了一种新的研究思路。
传统科学机器学习主要关注模型能否准确预测实验结果。
但在科学研究中,预测并不等同于理解。
如果AI能够准确预测一种复杂物理现象,却无法解释其依据,那么它在未知条件下的可靠性仍然难以判断。
神经网络表征几何学尝试从另一个方向突破这一问题:观察模型内部形成了怎样的表示结构,再研究这些结构是否对应现实世界的数学规律。
核质量预测模型的双螺旋研究,就是这一方向的代表。
类似的方法也具有拓展到分子性质预测、材料科学、动力系统、机器人运动控制以及工业设备状态识别的潜力。
例如,在工业设备故障诊断中,可以研究神经网络内部表示是否形成与工作周期、运动阶段、故障严重程度或不同工况有关的有序结构。
如果能够发现稳定的周期轨迹、状态流形或故障演化方向,就有可能进一步理解模型如何区分正常运行、渐进退化与异常状态。
但是,实际设备信号往往受到负载、速度、温度和环境噪声等因素影响。由此观察到的几何关系,必须经过独立工况数据和针对性的实验验证,才能获得工程意义。
十四、结语:从神经网络的几何形状寻找智能的计算规律
神经网络表征几何学正在改变人们理解深度学习的一种传统方式。
过去,研究者更多关注神经元、网络层、权重和注意力机制。
如今,一个新的观察角度正在形成:
神经网络不仅是在调整大量参数,还可能在高维空间中构造适合任务的几何表示。
周期性信息可能形成圆环,多个周期变量可能产生环面,分类特征可能趋向规则多面体,而某些科学预测任务则可能形成更复杂的螺旋或流形结构。
不过,漂亮的几何形状只是研究的起点,而不是终点。
真正有价值的研究,需要证明这些结构如何形成、表达什么信息、参与哪些计算,以及能否帮助人类建立新的数学模型和科学解释。
从发现形状,到理解机制,再到提取规律,这或许是神经网络表征几何学最值得关注的发展方向。
对于AI for Science而言,它所指向的目标尤为重要:不仅让AI给出正确答案,还要尽可能揭示答案背后可以被人类理解、检验和利用的科学规律。
参考资料
文献01|Interpretable AI reveals hidden structure in nuclear masses(2026)
https://www.nature.com/articles/s44488-026-00017-9
文献02|Nuclear_DNA — GitHub Research Code
https://github.com/strifinopoulos/Nuclear_DNA
文献03|Towards Understanding Grokking: An Effective Theory of Representation Learning(2022)
https://arxiv.org/abs/2205.10343
文献04|Progress measures for grokking via mechanistic interpretability(2023)
https://arxiv.org/abs/2301.05217
文献05|Not All Language Model Features Are One-Dimensionally Linear(ICLR 2025)
https://arxiv.org/abs/2405.14860
文献06|The Origins of Representation Manifolds in Large Language Models(2025)
https://arxiv.org/abs/2505.18235
文献07|Visualizing LLM Latent Space Geometry Through Dimensionality Reduction(2025)
https://arxiv.org/abs/2511.21594
文献08|Prevalence of neural collapse during the terminal phase of deep learning training(PNAS,2020)
https://doi.org/10.1073/pnas.2015509117
文献09|Toy Models of Superposition(2022)
https://www.anthropic.com/research/toy-models-of-superposition
文献10|Excitatory-inhibitory recurrent dynamics produce robust visual grids and stable attractors(Cell Reports,2022)
https://doi.org/10.1016/j.celrep.2022.111777
文献11|Toroidal topology of population activity in grid cells(Nature,2022)
https://www.nature.com/articles/s41586-021-04268-7
文献12|High-dimensional geometry of population responses in visual cortex(Nature,2019)
https://www.nature.com/articles/s41586-019-1346-5
文献13|Similarity of Neural Network Representations Revisited(ICML,2019)
https://proceedings.mlr.press/v97/kornblith19a.html
文献14|Representational similarity analysis – connecting the branches of systems neuroscience(2008)
https://doi.org/10.3389/neuro.06.004.2008
文献15|Position: The Platonic Representation Hypothesis(ICML,2024)
https://proceedings.mlr.press/v235/huh24a.html