看到一只杯子被推向桌边,我们往往会判断:再往前一点,它可能就要掉下去了。
作出这个判断时,我们不需要在脑海里画出下一秒的完整画面,也不必准确想象杯身上的每一道反光。杯子的位置、移动方向,以及它与桌边的距离,已经提供了重要线索。
AI 能否通过观察视频,学到类似的规律?
V-JEPA 探索的一条路径是:先把视频转换成内部的数字表征,再通过预测暂时看不到的内容,学习画面之间的联系。
这就引出了一个经常出现在 AI 研究中的词——“潜在空间”。
它究竟是什么?V-JEPA 怎样利用它学习?这种方法又如何与自动驾驶项目 LatentDrive 联系起来?
一、先认识三个名字:JEPA、V-JEPA与LatentDrive
这三个名字经常一起出现,可以先用一张表说明它们的关系。
| 名称 | 是什么 | 主要做什么 |
|---|---|---|
| JEPA | 一类学习架构 | 根据一部分信息的表征,预测另一部分信息的表征 |
| V-JEPA | 将 JEPA 思路用于视频的模型 | 从视频中的空间关系和时间变化中学习有用特征 |
| LatentDrive | TIER IV 推出的自动驾驶模型 | 利用视频特征,结合路线和车辆状态,生成行驶轨迹 |
JEPA 的全称是 Joint Embedding Predictive Architecture,通常译为“联合嵌入预测架构”。
名字很学术,核心思路却容易理解:把观察到的内容转换成内部特征,再让模型学习这些特征之间的预测关系。
这与杨立昆,也就是 Yann LeCun,长期倡导的研究方向密切相关。他在2022年的研究构想中提出,希望机器通过观察世界,形成能够支持预测和规划的内部模型。随后,Meta FAIR 等研究人员沿着这条路线,先后探索了面向图像的 I-JEPA,以及2024年公布的 V-JEPA。
V-JEPA 中的“V”,来自 Video,也就是视频。与单张图片相比,视频多了时间变化,更适合研究物体运动、动作过程,以及事物之间的相互影响。
2026年11月11日,TIER IV 发布的 LatentDrive,则展示了这种技术思路的一种应用:将视频中学到的潜在表征,用于驾驶轨迹生成。
二、“潜在空间”,可以理解为模型内部的数字笔记
一段视频包含大量像素。
颜色、纹理、阴影、反光,以及物体的位置和变化,都混在其中。模型需要把这些信息转换成适合后续计算的形式,承担这项工作的模块叫作编码器。
可以把编码器想象成一个做笔记的工具:它读取视频,把内容整理成一组组数字。这些数字就是“潜在表征”,也常被称为“潜在特征”。
不过,这份笔记有几个特点。
第一,数字的含义由模型自己学出来
人类可能会写下:“杯子正在向右滑动,距离桌边越来越近。”
模型内部通常没有这样一句现成的文字,而是用许多数字共同表达信息。与杯子、桌面、位置变化有关的线索,可能分散在不同特征中。
因此,不能随意认定某个数字专门表示“速度”,另一个数字专门表示“距离”。这些特征的表达方式,是模型在训练过程中逐渐形成的。
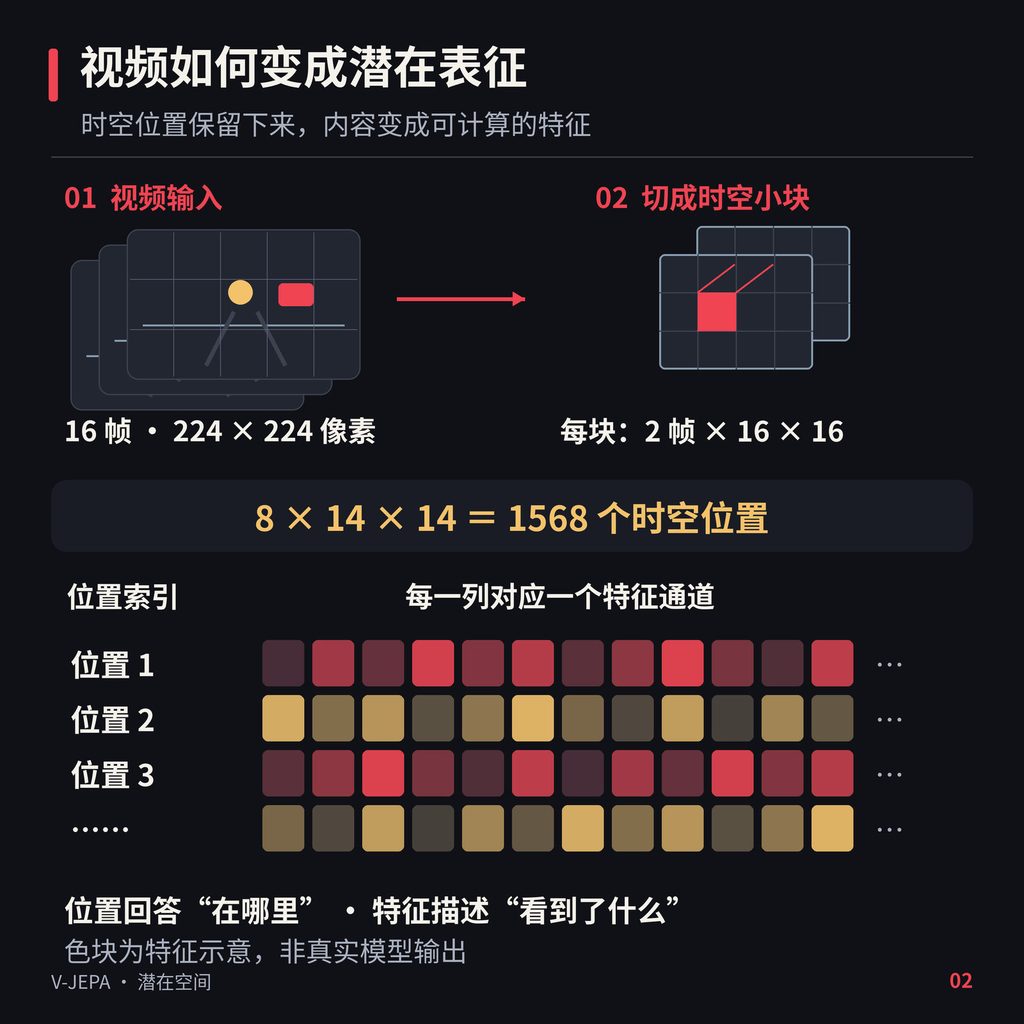
第二,视频会被组织成许多时空位置
模型会把视频切分为许多小块。每一块既占据画面中的一定区域,也覆盖一定的时间范围。
以原始 V-JEPA 的一种公开配置为例,输入的16帧画面,会被组织成1568个时空位置,每个位置都对应一组特征数字。
这些位置保留了信息的组织方式:它来自画面的哪里,又属于哪个时间片段。
所以,理解潜在表征时,可以把它想成一张带有时空索引的“数字笔记”,其中每个位置都记录着一组经过学习的特征。
第三,不同位置之间会交流信息
如果只看一小块画面,模型也许只能看到杯子的一部分。结合周围区域和其他时间片段,它才更有机会识别出与杯子、桌面及运动变化有关的线索。
V-JEPA 使用的神经网络会让不同位置的特征相互参考,再经过多层计算,形成包含上下文的信息。
潜在空间的作用,就是让视频内容以可计算的特征形式被组织、关联和预测。
三、V-JEPA怎样学习?先做一道“看不全的填空题”
训练时,V-JEPA 会故意遮住视频中的部分区域。
比如,杯子的一部分被遮住了,一些时间片段中的局部画面也被挡住了。模型需要根据剩下的可见线索,预测那些位置应该具有怎样的特征。
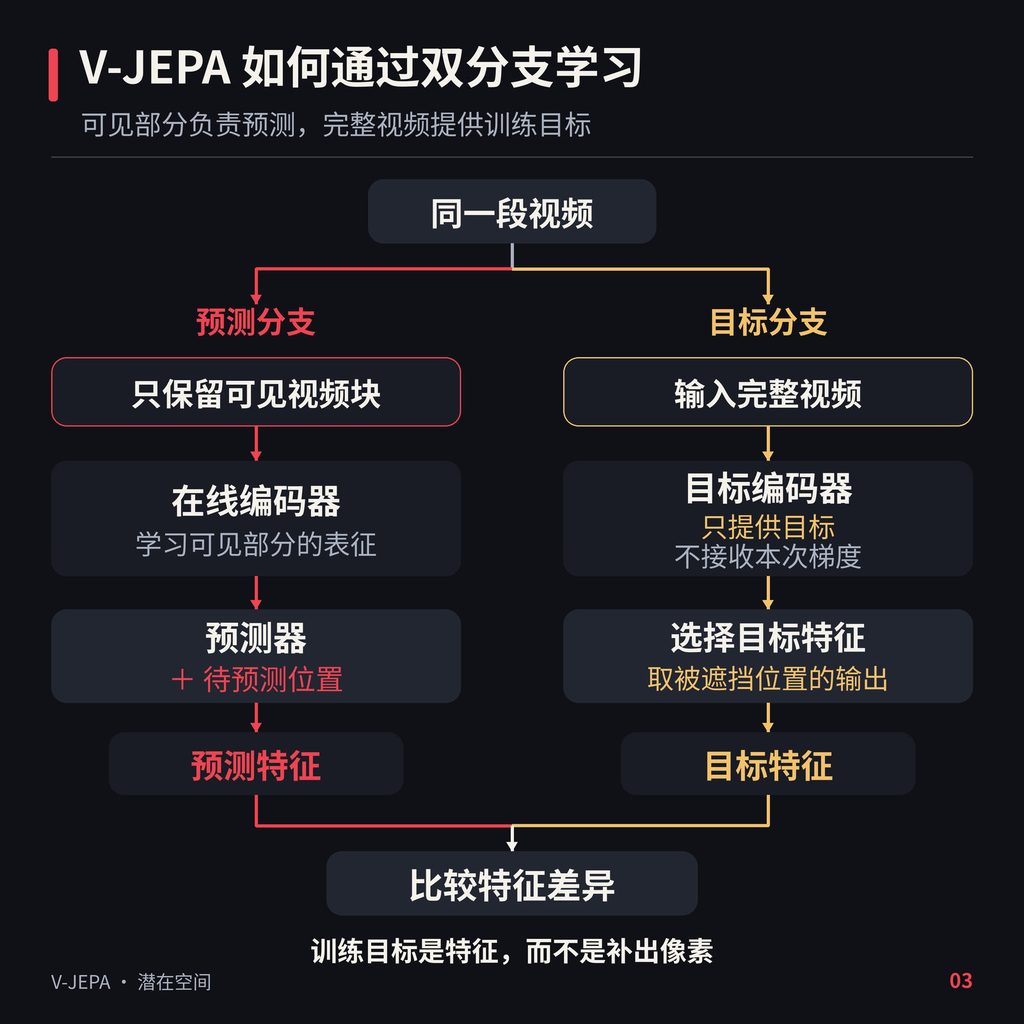
为了完成这个过程,训练系统设置了两条分支。
一条分支负责预测
这条分支只能接触未被遮挡的视频内容。
在线编码器先将可见内容转换成特征,再交给预测器。预测器同时获得需要预测的时空位置,然后输出相应位置的预测特征。
位置提示相当于告诉模型:“请预测这一段视频、这个位置的信息。”
它提供的是题目所在的位置,缺失的画面内容仍然需要模型根据上下文推测。
另一条分支提供训练目标
另一条分支使用目标编码器,读取完整视频,再取出被遮挡位置对应的特征,作为训练时的参照。
这样,系统就得到两份可以比较的数字描述:
- 一份是根据有限线索推测出来的特征。
- 另一份是目标编码器读取完整视频后得到的特征。
训练系统比较它们的差异,再据此调整模型。
在公开实现中,目标特征还会经过归一化处理。可以把它理解为:先把数字调整到较统一的尺度,再用来训练预测分支。
模型学习的目标,是特征之间的关系
这道“填空题”的答案,是一组特征数字。模型完成训练任务时,无需逐像素补画出被遮住的视频。
这种设计为模型留下了空间:它可以学习对预测更有帮助的信息,而不必把每一道反光、每一处细小纹理都复原出来。
这里的“训练目标”也是编码器生成的表征,并非人工写好的物理真相。它的优势在于,能够直接从视频自身构造学习信号,减少对逐段人工标注的依赖。
还有一个容易混淆的地方:原始 V-JEPA 的遮挡任务,可以利用视频中不同时间位置的可见信息。
因此,学习“缺失区域的特征”与严格意义上的“只看过去、预测未来”,需要区分开来。
四、预测出错以后,模型到底改了什么?
看到“潜在空间”这个说法,很容易想象:模型预测错了,就把空间里的某个点挪动一下。
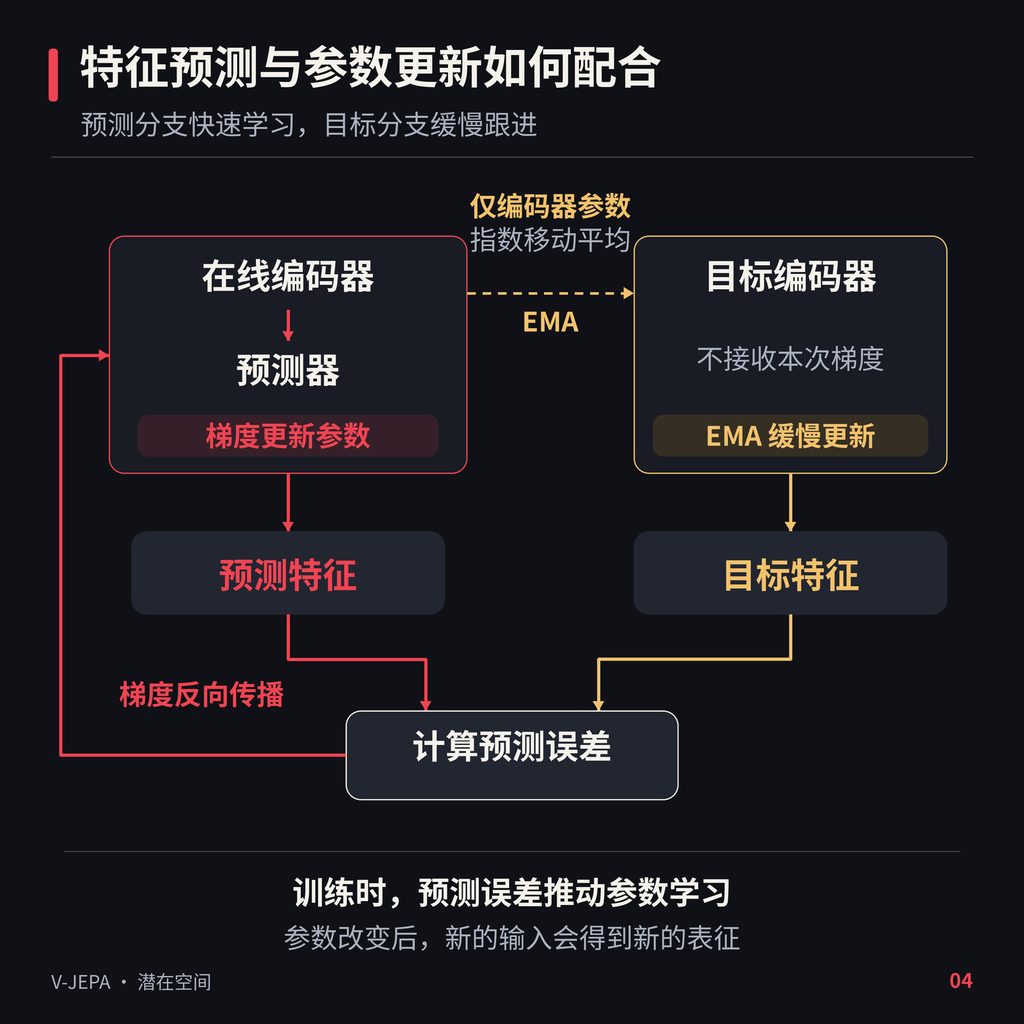
实际训练调整的,主要是网络参数。
参数可以理解为编码器和预测器内部大量可调节的设置。预测特征与目标特征存在差异时,训练算法会根据误差,修改在线编码器和预测器的参数。
下一次输入视频时,它们生成和处理特征的方式,就会发生变化。
随着训练持续进行,模型逐渐学会:怎样提取线索,怎样结合上下文,以及怎样作出更符合目标特征的预测。
为什么目标编码器要“慢一点”?
目标编码器承担着提供参照的任务,它的更新方式有所不同。
在当前这次比较中,它不直接接收误差的梯度更新,而是参考在线编码器的参数,缓慢跟进。
这种方式叫作“指数移动平均”,简称 EMA。可以理解为:每次保留较多原有参数,再吸收少量在线编码器的新变化。
这样,预测分支可以持续学习,目标分支则提供变化相对平稳的参照。
这里缓慢平均的是网络参数,不是视频帧,也不是每次计算得到的特征。
这项设计与预测器、停止梯度等安排共同配合,帮助模型学到有区分度的表示。否则,如果所有视频都被表示成同一组数字,即使预测误差很小,这样的特征也没有多少用处。
训练完成后,模型面对新视频时,通常使用已经学好的参数计算特征。日常使用模型,并不意味着每看一段视频,都要重新训练一次。
五、学到这份“数字笔记”以后,可以怎样使用?
潜在表征通常只是中间结果。
用户最终需要的,可能是“这个人在做什么”,也可能是“车辆接下来应该沿什么轨迹行驶”。
要把内部特征变成实际答案,还需要进一步处理。这里可以区分两种用法。
第一种:从特征中读出任务答案
在编码器后面接上一个任务模块,让它学习如何使用这些特征,就可以完成动作识别、分类等任务。
一种做法是固定已经学好的编码器,只训练后面的任务模块;也可以根据任务需要,对整体模型继续微调。
可以把这个过程理解为:前面的模型负责整理信息,后面的模块学习怎样利用这些信息回答问题。
这里也要区分两个角色:
预训练时的预测器,帮助模型通过预测学到表征;下游任务模块,则利用表征解决具体问题。
因此,将 V-JEPA 用于一个新任务,并不意味着必须原样运行预训练时的全部流程。
第二种:把动作条件加入预测
如果希望模型进一步回答“采取这个动作以后,会发生什么”,就需要让预测过程考虑动作本身。
2025年公布的 V-JEPA 2 研究探索了这个方向。其中的动作条件版本 V-JEPA 2-AC,通过动作与交互数据,学习行动与后续变化之间的联系。
例如,要把桌上的物体移动到目标位置,可以将整个过程理解为:
- 先把当前观察和目标观察转换成特征。
- 提出若干候选动作,预测执行后可能出现的状态特征。
- 将预测结果与目标特征比较,选择更合适的动作方案。
- 执行其中一步,重新观察环境,再继续规划。
这样,模型就可以在特征层面比较不同行动的可能后果,减少对生成完整未来画面的依赖。
这里搜索和比较的是动作方案。未来特征则由动作条件模型计算出来,不能靠人为规定“把某个特征数字调大,就代表向左移动”。
也正因为如此,从视频中学到表征、预测行动后果、选择下一步动作,是相互衔接的几个环节。
其中任何一环是否有效,都需要在具体任务中验证。
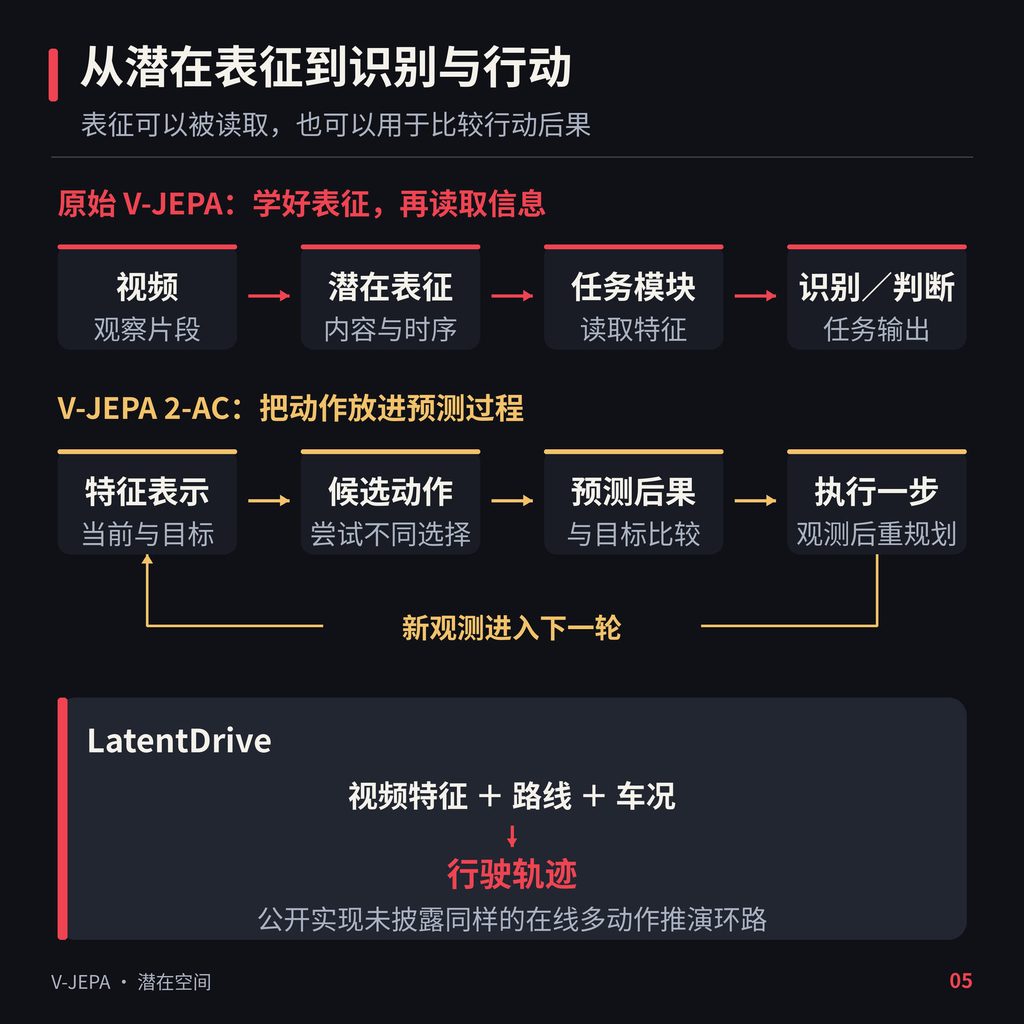
六、回到LatentDrive:潜在表征怎样进入自动驾驶?
按照 TIER IV 的公开介绍,LatentDrive 利用 V-JEPA 相关技术,从摄像头视频中提取潜在特征,再结合路线信息和车辆状态,生成接下来约四秒的行驶轨迹。
从信息处理的角度看,这个过程可以理解为:
先从视频中提取环境特征,再由规划模块综合“周围是什么情况”“准备往哪里走”“车辆目前怎样运动”等信息,输出行驶轨迹。
它体现了视频表征的一项应用价值:从视频中学到的内部特征,可以继续服务于驾驶决策。
对于端到端系统来说,这也提供了一种选择——让规划模块直接利用较丰富的视觉特征,减少将信息反复转换成单独目标、轨迹等中间结果的过程。
不过,理解 LatentDrive 时,需要把它与前面介绍的 V-JEPA 2-AC 区分开来。
目前公开的 LatentDrive 结构,重点是将视频特征输入规划模块,结合路线与车况生成轨迹。公开材料并未披露与前述动作条件规划相同的在线循环,例如逐一推演多组候选动作,再根据与目标的距离选出动作。
因此,更准确的表述是:LatentDrive 展示了视频潜在表征在驾驶轨迹生成中的一种应用方式。
根据发布时的官方说明,其 Autoware 集成和车载环境验证仍在推进。实际表现,还需要结合具体测试与验证结果来判断。
V-JEPA 这条研究路线的吸引力,在于让 AI 通过观察,学会组织和预测世界的信息;LatentDrive 等应用,则把这些内部表征带入了具体任务。
从视频到特征,从特征到预测,再从预测走向行动——这些环节能否可靠地连接起来,将决定这种方法能够发挥多大的价值。
参考资料
1)I-JEPA: The first AI model based on Yann LeCun’s vision for more human-like AI JEPA 研究背景与图像版本的官方介绍。ai.meta.com https://ai.meta.com/blog/yann-lecun-ai-model-i-jepa/
2)Revisiting Feature Prediction for Learning Visual Representations from Video 原始 V-JEPA 论文。arxiv.org https://arxiv.org/abs/2404.08471
3)V-JEPA: The next step toward Yann LeCun’s vision of advanced machine intelligence V-JEPA 的官方介绍,包含特征预测、遮挡训练和下游应用的说明。ai.meta.com https://ai.meta.com/blog/v-jepa-yann-lecun-ai-model-video-joint-embedding-predictive-architecture/
4)V-JEPA 官方训练代码:app/vjepa/train.py 目标特征生成、归一化、误差计算和参数更新的公开实现。GitHub https://github.com/facebookresearch/jepa/blob/main/app/vjepa/train.py
5)V-JEPA 官方训练配置:configs/pretrain/vitl16.yaml 文中视频帧数、时空切块等示例所依据的配置。GitHub https://github.com/facebookresearch/jepa/blob/main/configs/pretrain/vitl16.yaml
6)V-JEPA 2: Self-Supervised Video Models Enable Understanding, Prediction and Planning V-JEPA 2 与动作条件版本 V-JEPA 2-AC 的研究论文。arxiv.org https://arxiv.org/abs/2506.09985
7)TIER IV unveils end-to-end autonomous driving adaptable to map information and sensor configurations 包含 LatentDrive 的技术定位、输入信息、轨迹输出和验证进展。tier4.co.jp https://tier4.co.jp/en/updates/press-release/20261111-tieriv-unveils-e2e-autonomous-driving
8)AutowareFoundation/latent_drive — Model Card LatentDrive 官方模型说明。Hugging Face https://huggingface.co/AutowareFoundation/latent_drive
9)autoware_latent_drive — Technical Details LatentDrive 项目的公开技术说明。GitHub https://github.com/autowarefoundation/autoware_latent_drive/blob/main/docs/details.md