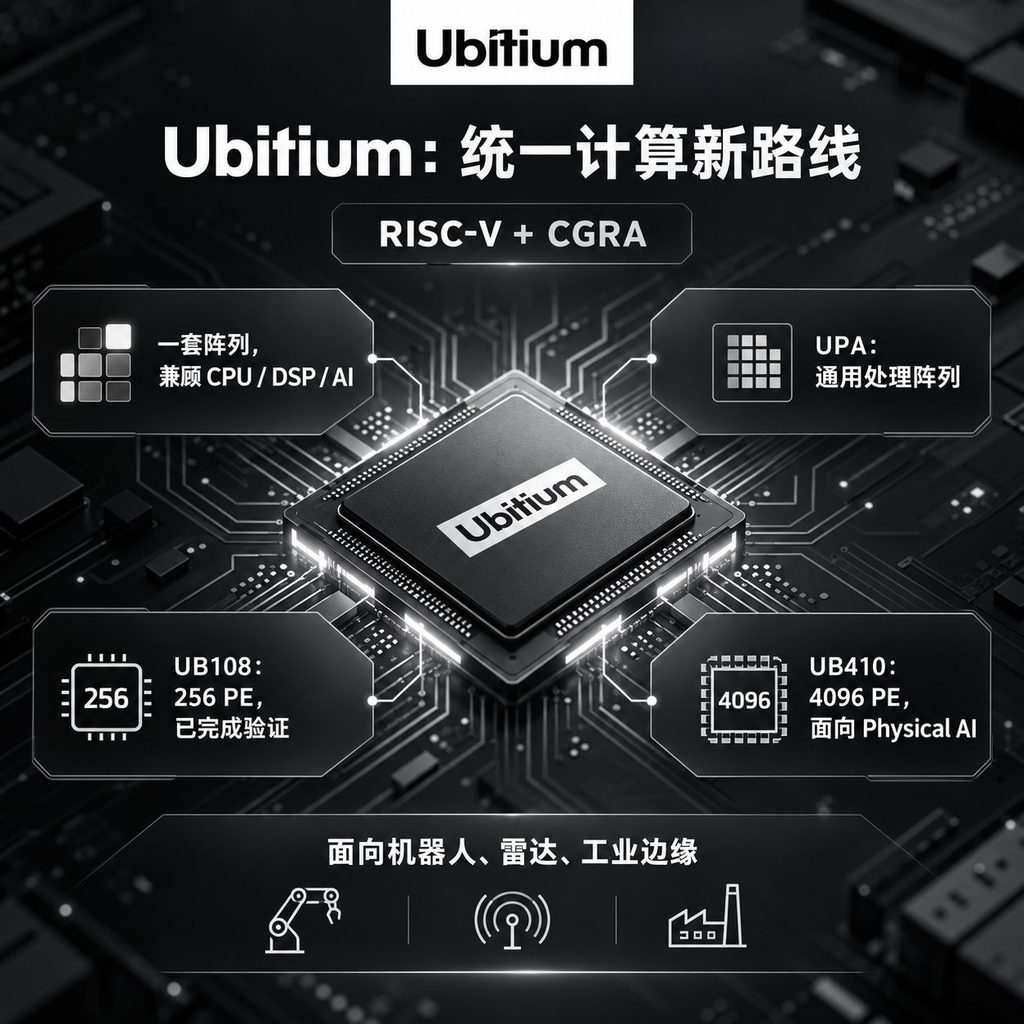
Ubitium 是一家成立于 2024 年的德国无晶圆厂(Fabless)半导体初创企业,总部位于德国杜塞尔多夫。其核心技术是将 RISC-V 指令集与 CGRA(Coarse-Grained Reconfigurable Architecture,粗粒度可重构架构)结合,开发面向 Physical AI、机器人、无人机及工业边缘计算的新型通用处理器。
Ubitium 提出了一个颇具挑战性的技术目标:不再为不同计算任务分别配置 CPU、GPU、DSP、NPU 等专用处理单元,而是通过一种可动态重构的通用处理器架构,完成这些任务。
2026 年 10 月 13 日,Ubitium 宣布新获得 1400 万美元种子融资,累计种子融资达到 1800 万美元。与此同时,公司已完成首颗测试芯片 UB108 的制造和初步技术验证,正推进首款商业处理器 UB410 的开发。
这家公司值得关注的地方,不仅在于它试图设计一种新型 RISC-V 芯片,更在于它提出了一条不同于当前主流异构 SoC 的技术路线:
从“多个专用计算核心协同工作”,转向“同一组计算资源根据工作负载实时改变执行方式”。
但需要区分:截至 2026 年 10 月,Ubitium 已经证明了部分核心架构的可行性,尚未证明它能在性能、功耗和成本上全面取代成熟的 CPU、GPU 或 FPGA 产品。
一、公司背景与最新发展
Ubitium 的核心创始团队具有较强的可重构计算技术背景。
- Hyun Shin Cho(联合创始人、CEO):具有汽车、工业、国防及数字化平台相关行业经验。
- Martin Vorbach(联合创始人、CTO):长期从事可重构处理器研发,曾创立 PACT XPP Technologies,在相关处理器架构领域拥有大量专利。
- Peter W. Weber(联合创始人):曾在 Intel、Texas Instruments 等半导体企业任职。
- Markus Weinhardt(编译器首席架构师):具有 PACT XPP 编译器开发经验,是公司软件工具链的重要技术人员。
其研发和产业化进展如下:
| 时间 | 进展 |
|---|---|
| 2024 年 | 公司成立,启动通用可重构处理器研发 |
| 2025 年 8 月 | 宣布与 ADTechnology 合作,推进芯片设计制造 |
| 2025 年 12 月 | 首颗测试芯片完成流片 |
| 2026 年 4 月 | 宣布在 FPGA 原型上实现 CGRA 无外部主机 CPU 启动 Linux |
| 2026 年 7 月 | 首颗芯片样片返回,进入测试验证 |
| 2026 年 10 月 | 完成新一轮 1400 万美元融资,公布 UB108、UB410 的最新规划 |
| 2027 年(计划) | UB410 商业芯片流片并交付客户评估样片 |
技术和制造合作方包括 Samsung Foundry、ADTechnology 和 Siemens Digital Industries Software,涉及晶圆制造、后端芯片设计及 EDA 验证。
二、产品分析:UB108 与 UB410
Ubitium 当前的产品路线十分明确:先以小规模芯片验证架构,再扩展计算阵列,形成面向工业及 Physical AI 的商业处理器。
1. UB108:架构验证芯片
UB108 是 Ubitium 首颗用于架构验证的芯片。
其主要特点包括:
- 采用 Samsung 8nm 工艺。
- 集成 256 个处理单元(Processing Elements,PE)。
- 支持可重构计算阵列。
- 用于验证信号处理、AI 推理和实时控制等工作负载能否在同一阵列上运行。
- 已完成制造并进入实际硅片验证阶段。
UB108 的主要价值不是直接面向大规模销售,而是验证 Ubitium 提出的统一处理器架构是否可行。
对于一家采用全新架构的芯片初创企业而言,从仿真模型、FPGA 原型到实际硅片,是一个重要的技术跨越。
不过,UB108 的存在并不意味着整套架构已经具备成熟的商业竞争力,特别是尚需通过实际测试证明其性能、功耗和软件工具链的优势。
2. UB410:首款商业化处理器
UB410 是 Ubitium 正在开发的首款商业处理器。
根据当前公开规划,其主要特点包括:
- 集成 4096 个处理单元。
- 计算阵列规模为 UB108 的 16 倍。
- 支持通用控制、信号处理及 AI 推理等不同工作负载。
- 面向雷达、音频、工业感知和自主系统等领域。
- 计划于 2027 年完成流片并交付客户评估样片。
需要注意,处理单元数量增加 16 倍,并不意味着实际应用性能一定增加 16 倍。
对于 CGRA 架构,最终性能不仅取决于计算单元数量,还受到片上互连、存储带宽、计算任务划分和编译器效率等因素影响。
目前尚未看到 UB410 完整公开的数据手册,以及足以用于工程选型的关键参数,例如主频、典型功耗、AI TOPS、内存带宽、芯片价格、工业温度等级和量产供货保障。
因此,UB410 目前应视为具有明确产品规划、但尚未完成商业验证的芯片。
三、核心技术:Universal Processing Array(UPA)
这是理解 Ubitium 的关键。
1. 传统 SoC 与 Ubitium 的区别
目前大多数边缘 AI SoC 采用异构计算架构,即把多个功能不同的计算核心集成到一颗芯片上。
例如:
- CPU:负责操作系统、逻辑控制和任务调度。
- DSP:负责 FFT、数字滤波等信号处理任务。
- GPU:负责图形处理和大规模并行计算。
- NPU:负责神经网络推理。
- MCU 或实时控制单元:负责确定性控制任务。
这种方式的优点是每种计算核心针对特定任务进行了优化,性能和能效比较容易发挥。
但是,异构架构也存在一些问题。
首先,不同处理器之间需要传输数据。例如,传感器数据可能先由 DSP 处理,再交给 NPU 进行推理,最后由 CPU 完成控制决策。
这一过程中可能涉及数据复制、缓存同步、驱动调用和任务调度,产生额外延迟。
其次,不同专用计算单元的利用率可能不均衡。例如,某一时刻 NPU 非常繁忙,而 GPU 或 DSP 基本处于空闲状态。
最后,异构架构的软件开发比较复杂,需要分别管理不同计算核心的程序、内存和任务调度。
Ubitium 的解决思路是使用统一处理阵列 UPA(Universal Processing Array)。
UPA 由大量可编程处理单元组成,通过改变计算任务的执行方式以及处理单元之间的数据流动方式,使同一批硬件能够承担不同计算角色。
这不是简单地把 CPU、GPU、DSP 封装在一起,而是尝试让同一组硬件计算资源同时具备通用处理和专用加速能力。
2. 三种主要执行模式
Ubitium 的统一处理阵列主要支持三种执行模式。
| 模式 | 技术原理 | 适用任务 |
|---|---|---|
| O-mode(乱序执行) | 根据数据依赖和操作数就绪状态调度指令 | 操作系统、控制逻辑、不规则计算 |
| L-mode(循环加速) | 将循环展开并映射成空间数据流流水线 | FFT、滤波、矩阵及重复计算 |
| S-mode(线程加速) | 采用类似 GPU 的 SIMT 并行执行 | AI 推理、向量计算、数据并行任务 |
O-mode:让 UPA 像 CPU 一样工作
O-mode 主要针对通用计算任务。
传统高性能 CPU 通常采用乱序执行(Out-of-Order Execution)技术,通过寄存器重命名、保留站、重排序缓冲区等硬件机制管理指令调度。
Ubitium 则采用数据驱动的执行思路。
简单来说,当某条指令所需的数据已经准备好时,相应处理单元便可以执行计算,而不必严格按照程序中的原始指令顺序等待。
通过这种机制,UPA 可以处理存在复杂数据依赖关系的通用程序。
Ubitium 宣称,这种执行方式能够减少传统乱序调度硬件的部分开销,同时支持多个指令流共享处理阵列。
不过,实际能否达到或超越成熟 CPU 的执行效率,还需要通过标准基准测试验证。
L-mode:让 UPA 像 DSP 或数据流加速器一样工作
L-mode 主要面向重复计算密集的任务。
例如,FFT、FIR 滤波、矩阵运算以及部分数字信号处理算法,都需要执行大量具有固定规律的计算。
传统 CPU 通常依靠循环指令和 SIMD 向量单元完成这些任务。
UPA 则可以尝试把循环中的计算步骤展开,并映射到多个处理单元,形成空间计算流水线。
以 FFT 为例,部分蝶形运算及其数据依赖关系可以被映射到不同计算单元。
数据从一个单元流向下一个单元,在计算过程中形成流水线,而不必为每一步都执行完整的传统指令获取与调度过程。
这种空间数据流计算方式是 CGRA 的典型优势。
对于执行规律明确、重复次数较多的信号处理任务,理论上能够提高吞吐率并降低部分指令控制开销。
S-mode:让 UPA 像 GPU 一样工作
S-mode 主要针对高度并行的计算任务。
例如,神经网络推理时,大量输入数据需要执行相似的数学运算。
GPU 通常采用 SIMT(Single Instruction, Multiple Threads,单指令多线程)模式,让大量线程执行相似的指令序列。
Ubitium 的 S-mode 采用类似思路,使多个处理单元能够在不同数据上执行相同或相似的计算。
这种方式适合:
- 神经网络中的张量运算。
- 大规模向量计算。
- 图像和传感器数据的并行处理。
- 其他规则的数据并行任务。
Ubitium 的目标是让处理阵列可以在这些模式之间动态切换,从而降低传统异构架构中不同处理器之间卸载任务和传递数据的开销。
不过,三种模式并不代表任何程序都可以自动获得最佳性能。实际效果仍依赖工作负载的结构和编译器的映射能力。
3. 为什么 RISC-V 很重要?
Ubitium 并非单纯开发一款 CGRA 加速器,而是将其与 RISC-V 指令集结合,试图形成能够独立运行通用软件的处理器。
需要区分两个概念:
RISC-V 是指令集架构,CGRA 是微架构层面的计算资源组织方式。
RISC-V 主要解决软件与处理器之间的指令兼容问题。
CGRA 则解决计算单元如何连接、指令如何执行、数据如何流动的问题。
两者并不冲突,可以相互结合。
Ubitium 的技术重点,就是在遵循标准 RISC-V 软件接口的同时,使底层硬件具有动态可重构执行能力。
2026 年 4 月,公司宣布已经在 FPGA 原型平台上实现无需外部主机 CPU 启动标准 Linux。
这一进展非常重要。
传统 CGRA 通常作为 CPU 或 SoC 内部的加速器使用,需要外部处理器负责系统启动、程序管理和任务调度。
如果 CGRA 本身能够独立运行 Linux,就说明其设计已经具备承担部分通用处理器功能的能力。
但需要强调:
能够运行标准 RISC-V 软件,不等于所有程序都能够自动获得高性能。
尤其是在 L-mode 和 S-mode 下,编译器仍然需要识别并行性、分配计算资源、组织数据流并减少通信开销。
因此,Ubitium 的编译器和软件开发工具链,也是决定其商业成败的重要技术环节。
四、与 FPGA、传统 CPU 和 Edge AI 加速器比较
Ubitium 的技术与 FPGA、CPU 和 AI 加速器都有一定关联,但并不完全相同。
| 维度 | CPU | FPGA | Ubitium UPA |
|---|---|---|---|
| 基本结构 | 固定指令执行核心 | 可编程逻辑与互连 | 可重构处理单元阵列 |
| 重构粒度 | 主要通过软件改变行为 | 位级、逻辑级 | 运算级、字级 |
| 开发方式 | C/C++ 等 | RTL、HLS | 主要面向 RISC-V 软件 |
| 动态调整 | 软件调度为主 | 可局部动态重构 | 运行时改变执行模式 |
| 通用控制计算 | 强 | 需软核、硬核或专门设计 | 架构支持,效率待验证 |
| 任意数字逻辑电路 | 不适用 | 强 | 不适合作为通用逻辑替代 |
| 产业成熟度 | 高 | 高 | 早期验证 |
1. Ubitium 与 FPGA 的区别
Ubitium 与 FPGA 都具有可重构特征,但重构粒度不同。
FPGA 的可编程资源主要包括查找表、寄存器、可编程互连,以及 DSP、BRAM 等专用硬核。
开发人员可以利用这些资源构造不同的数字电路。
例如,可以在 FPGA 中实现高速串行接口控制、专用数据处理流水线、复杂状态机,甚至完整的软核处理器。
FPGA 的本质是可编程数字逻辑硬件。
而 Ubitium 的 UPA 本质上仍然是一种处理器架构。
它的处理单元具有预先定义的基本计算能力,通过软件和运行时配置改变执行模式,而不是像 FPGA 那样任意构造底层逻辑电路。
因此,Ubitium 的可重构性主要体现在计算资源的组织与执行方式上,而非任意数字逻辑功能的实现。
Ubitium 可能替代部分采用 FPGA 完成的信号处理和 AI 计算任务,但不能直接替代 FPGA 的全部功能。
例如,某些高精度时序接口、特殊通信协议、并行硬件状态机等,仍然更适合 FPGA。
2. Ubitium 与传统 CPU 的区别
传统 CPU 面向通用程序执行,通过缓存、分支预测、乱序执行和 SIMD 等技术提高性能。
Ubitium 则尝试使用同一组处理单元,在通用执行和空间并行计算之间切换。
因此,两者的主要区别不是是否支持 RISC-V,而是底层微架构的组织方式。
传统 CPU 更偏向优化通用指令执行效率,而 Ubitium 试图同时提高通用计算与规则并行计算的资源利用率。
但对于高度复杂的分支、频繁随机访存以及不规则数据结构,成熟 CPU 仍可能具有明显优势。
3. Ubitium 与 EdgeCortix DNA 技术的区别
EdgeCortix 也是采用动态可重构技术的 AI 芯片企业。
其 DNA(Dynamic Neural Accelerator)架构主要面向神经网络推理,通过调整计算资源和数据通路,提高不同 AI 模型的执行效率。
Ubitium 的 UPA 则更加注重计算通用性。
| 维度 | Ubitium UPA | EdgeCortix DNA-II |
|---|---|---|
| 核心定位 | 通用处理器架构 | 神经网络加速架构 |
| 计算范围 | 通用计算、信号处理、AI 推理 | 重点优化 AI 推理 |
| 主机处理器 | 目标是不需要独立主机 CPU | DNA-II 可与主机处理器配合 |
| 编程生态 | RISC-V、Linux、RTOS | MERA 编译框架 |
| 产品阶段 | UB108 已验证,UB410 待交付 | 已形成 SAKURA-II 芯片与模块 |
两者都采用动态可重构的设计思想,但技术目标不同。
EdgeCortix DNA-II 主要解决 AI 模型在计算单元之间如何高效执行的问题。
Ubitium 则进一步探索,能否让同一阵列同时承担通用计算和专用计算任务。
值得注意的是,EdgeCortix 的新一代 RAIDEN 平台也开始将信号处理、控制计算与 AI 推理纳入整体架构,不过采用的是 RISC-V 核心与可编程加速引擎协作的异构方案。
这反映出一个共同趋势:
边缘 AI 芯片正在从单纯追求 AI TOPS,转向优化感知、推理、决策和控制的整体工作负载。
五、Ubitium 的主要应用市场
1. 雷达与传感器融合
这是 Ubitium 目前优先关注的市场之一。
典型雷达处理流程包括:
传感器数据采集、FFT、数字滤波、目标检测、目标识别和后续控制决策。
在传统系统中,这些功能可能由 DSP、CPU 和 AI 加速器分别承担。
UPA 则可以尝试在同一处理阵列中执行这些任务,减少不同计算模块之间的数据传输和调度开销。
对于车载毫米波雷达、工业雷达及其他智能传感器系统,这种架构具有一定吸引力。
尤其是在计算工作负载随运行阶段发生变化时,同一阵列的动态资源复用可能带来优势。
2. 工业机器人与边缘控制
工业机器人通常需要执行多种计算任务,例如:
- 编码器及其他传感器数据处理。
- 电机控制和状态估计。
- 轨迹规划与运动学计算。
- 机器视觉及 AI 推理。
- 故障诊断和设备管理。
传统架构可能采用 MCU、FPGA、DSP、CPU 和 NPU 等多个处理单元。
Ubitium 希望通过统一处理器减少计算平台的复杂性。
例如,在机器人运行过程中,部分处理资源可以用于传感器数据处理,部分处理资源用于 AI 推理,其他资源用于通用控制任务。
但工业控制领域有一个非常重要的问题:实时确定性。
机器人控制任务不仅要求计算速度快,还要求响应时间稳定、可预测。
因此,Ubitium 是否能够满足严格的实时控制需求,需要进一步考察其任务调度、最坏执行时间以及中断响应等方面的表现。
特别是涉及功能安全的工业应用,不能仅凭统一架构就认定其可以替代专用安全控制器。
3. 无人机及自主系统
无人机通常对以下指标比较敏感:
- 处理器功耗。
- 板级面积和重量。
- 传感器处理延迟。
- AI 推理速度。
- 任务切换效率。
一架自主无人机可能需要同时完成视觉感知、目标识别、定位、路径规划和飞行控制。
如果通过统一计算平台减少处理器数量和数据传输,可能有助于降低系统重量、功耗及设计复杂度。
不过,其实际优势仍取决于 UB410 的性能功耗比、片上存储容量及外部存储带宽等指标。
4. 工业设备故障诊断
对于工业设备状态监测,Ubitium 的架构也具有潜在应用价值。
例如电机和其他机电设备的监测系统,可能需要对振动、电流、磁场等信号进行实时分析。
典型计算流程包括:
传感器采集 → 数字滤波 → FFT → 特征提取 → AI 异常检测 → 状态判断。
这里包含多种不同类型的计算任务。
数字滤波和 FFT 具有明显的数据流计算特征;AI 异常检测适合并行加速;状态判断和设备通信则属于通用控制计算。
如果使用统一处理阵列,就可以尝试在一颗芯片上完成上述计算。
但对于计算量较小的工业监测设备,传统 MCU、DSP 或低功耗边缘 AI SoC 已经能够满足需求。
因此,Ubitium 在这一领域能否体现成本、功耗和开发效率优势,还需通过实际应用进行比较。
六、技术优势与主要风险
1. 潜在技术优势
第一,减少异构计算开销。
多个功能模块共用计算阵列和地址空间,可以减少部分跨设备的数据传输、驱动调用和中间缓冲。
特别是在数据需要连续经过信号处理、AI 推理和控制决策的场景下,这种架构具有潜在优势。
第二,提高硬件资源复用率。
传统异构 SoC 中,不同加速器往往具有独立的专用计算资源。
当某类任务暂时不运行时,相应计算单元可能处于空闲状态。
UPA 则尝试让同一组处理单元承担不同角色,根据工作负载变化重新配置计算资源。
这有可能提高整体硬件利用率,减少部分闲置专用加速器所占用的芯片面积。
第三,降低软件开发和系统维护复杂度。
如果一颗处理器既能够运行 Linux 或 RTOS,又能够高效执行信号处理和 AI 推理,那么开发人员可能不再需要管理多个独立处理器的软件工具链。
RISC-V 生态也为软件移植和开发工具支持提供了基础。
但这一优势能否实现,仍然取决于 Ubitium 编译器、调试工具和运行时系统的成熟度。
第四,适应不断变化的算法。
工业 AI 和 Physical AI 的算法更新较快。
如果底层硬件可以通过软件重新组织执行方式,就能在一定程度上适应新算法,而无需每次都重新设计专用计算电路。
对于产品生命周期较长的工业设备,这种灵活性具有一定价值。
2. 主要技术与商业风险
风险一:缺少独立性能测试
目前 Ubitium 尚未公开足够完整的标准化性能、功耗和成本数据。
例如:
- UB410 的典型与峰值功耗是多少?
- FFT、FIR 等信号处理任务的吞吐率如何?
- AI 推理实际可以达到多少 TOPS?
- 多种工作负载同时运行时,能否保持低延迟?
- 与同等工艺和功耗条件下的 CPU、DSP、FPGA、NPU 相比,性能提升多少?
这些问题尚缺少充分的公开证据。
因此,目前不能简单认定 Ubitium 在综合性能上优于传统架构。
风险二:编译器开发难度较高
对于拥有数千个处理单元的可重构阵列,编译器必须解决大量复杂问题。
例如,如何将程序拆分成能够并行执行的任务,如何安排不同处理单元之间的数据传输,以及如何避免计算资源空闲或互连拥塞。
如果编译器无法高效映射工作负载,即使硬件提供了大量处理单元,也可能难以发挥理论性能。
这也是 CGRA 技术发展过程中长期存在的挑战之一。
风险三:通用性与专用效率之间存在权衡
专用 AI ASIC 可以针对矩阵乘法、卷积和张量计算进行高度优化。
FPGA 可以针对特定数字电路和数据通路进行定制。
CPU 则经过长期演进,对通用程序执行具有较高效率。
Ubitium 试图使用一种统一架构覆盖这些计算任务,必然面临通用性和专用效率之间的权衡。
例如,对于大型 Transformer 推理,专用 AI 加速器可能具有更高的计算密度和内存优化效率。
对于精确硬件时序控制,FPGA 可能更有优势。
因此,Ubitium 更可能在混合负载下体现系统整体效率优势,而不是在每一种计算任务上都超过专用芯片。
风险四:产业化仍处于早期阶段
Ubitium 虽然已经完成 UB108 的硅片验证,但首款商业处理器 UB410 尚未交付。
2025 年的合作公告曾提出 2026 年末至 2027 年初的量产目标,而最新公告已将 UB410 的评估样片安排在 2027 年。
这意味着目前仍需重点关注其后续流片、芯片测试、软件生态建设和客户验证进展。
尤其对于工业、汽车和安全相关市场,芯片性能只是产品准入条件之一。
长期供货能力、可靠性、温度适应性和功能安全支持,同样是重要因素。
七、综合判断
Ubitium 代表的并不是一种全新的计算理论,而是对已有 CGRA、数据流计算、乱序执行和 RISC-V 技术的一次系统性重新组合。
它真正具有挑战性的创新在于:
能否把过去主要用作加速器的 CGRA,发展成既能独立运行通用操作系统,又能高效执行 DSP 和 AI 工作负载的主处理器。
从当前技术进展看,可以作出三个阶段性判断。
| 评价维度 | 判断 |
|---|---|
| 架构创新性 | 较高,尤其是统一通用执行和空间数据流计算 |
| 技术可行性 | 已有初步硅片证据,但大规模阵列性能尚待验证 |
| 商业成熟度 | 处于早期,首款商业产品尚未正式交付 |
未来最值得观察的节点是 2027 年 UB410 评估样片发布。
届时应重点考察几个方面:
- 综合性能:在雷达信号处理、AI 推理和控制任务混合运行时,端到端延迟表现如何。
- 能源效率:在相同工作负载和相近工艺条件下,与传统异构 SoC 相比能否降低功耗。
- 计算资源利用率:4096 个处理单元是否能够在实际程序中保持较高利用率。
- 软件工具链:编译器能否自动、高效地映射复杂应用,而不需要大量底层人工优化。
- 成本与产业生态:是否能够在芯片成本、开发工具、驱动支持和长期供货等方面建立竞争力。
如果 Ubitium 能在这些指标上取得具有竞争力的结果,它可能为工业边缘计算、机器人和 Physical AI 提供一种不同于传统异构 SoC 的计算平台。
反之,如果高度通用的执行阵列无法有效匹配复杂工作负载,最终仍需要大量依赖专用计算单元,那么其产品就可能演变成另一种异构 SoC。
从更广泛的半导体发展趋势来看,Ubitium 的技术探索具有一定代表性。
过去,芯片产业不断增加专用加速器,以提高特定算法的性能和能效。而随着边缘 AI、机器人和自主系统的发展,应用程序往往需要在同一设备上连续执行信号处理、智能推理与控制决策等多类任务。
这使得处理器设计开始重新关注计算资源复用、跨任务数据流动以及系统级效率。
Ubitium 选择的方向是提高单一计算阵列的通用性,而另一些企业则继续采用多个专用加速器协同工作的异构路线。
两条技术路线并不一定相互排斥,未来也可能长期共存。
总体而言,Ubitium 值得持续关注,但当前更适合将其定义为“已经完成初步硅片验证的新型可重构处理器公司”,而不是已经成熟的 CPU、GPU、DSP、FPGA 通用替代者。
其长期价值,将取决于能否把具有吸引力的架构理念真正转化成具备性能、能效、成本和软件生态优势的商业芯片。
参考文献
以下参考文献可直接添加在上一篇文章末尾。文中保持不出现参考链接,所有资料统一列于文后。
1. Ubitium Raises $14 Million to Build the First Universal Processor for Physical AI(2026年10月13日) https://www.ubitium.com/ubitium-raises-14-million-to-build-the-first-universal-processor-for-physical-ai/
2. Ubitium Tapes Out Universal Processor to End Embedded Computing Complexity Crisis(2026年3月9日) https://www.ubitium.com/ubitium-tapes-out-universal-processor-to-end-embedded-computing-complexity-crisis/
3. Ubitium Becomes the World’s First CGRA to Execute Linux Without a Host(2026年4月27日) https://www.ubitium.com/ubitium-becomes-the-world-firsts-cgra-to-execute-linux-without-a-host/
4. Our Technology — Ubitium(技术架构介绍) https://www.ubitium.com/technology/
5. Workload Agnostic Processing(2025年10月2日) https://www.ubitium.com/workload-agnostic-processing/
6. Ubitium and ADTechnology Collaborate to Bring Universal Processor to Market(2025年8月6日) https://www.ubitium.com/ubitium-and-adtechnology-collaborate-to-bring-universal-processor-to-market/
7. Dynamic Neural Accelerator-II Architecture — EdgeCortix(动态可重构 AI 加速架构) https://www.edgecortix.com/en/products/dna
8. Survey of Coarse-Grained Reconfigurable Architectures Mapping Algorithms(Journal of Computer Science and Technology,2026) https://doi.org/10.1007/s11390-026-5611-4
9. Coarse-grained Reconfigurable Architectures for Radio Baseband Processing: A Survey(Journal of Systems Architecture,2024) https://doi.org/10.1016/j.sysarc.2024.103243