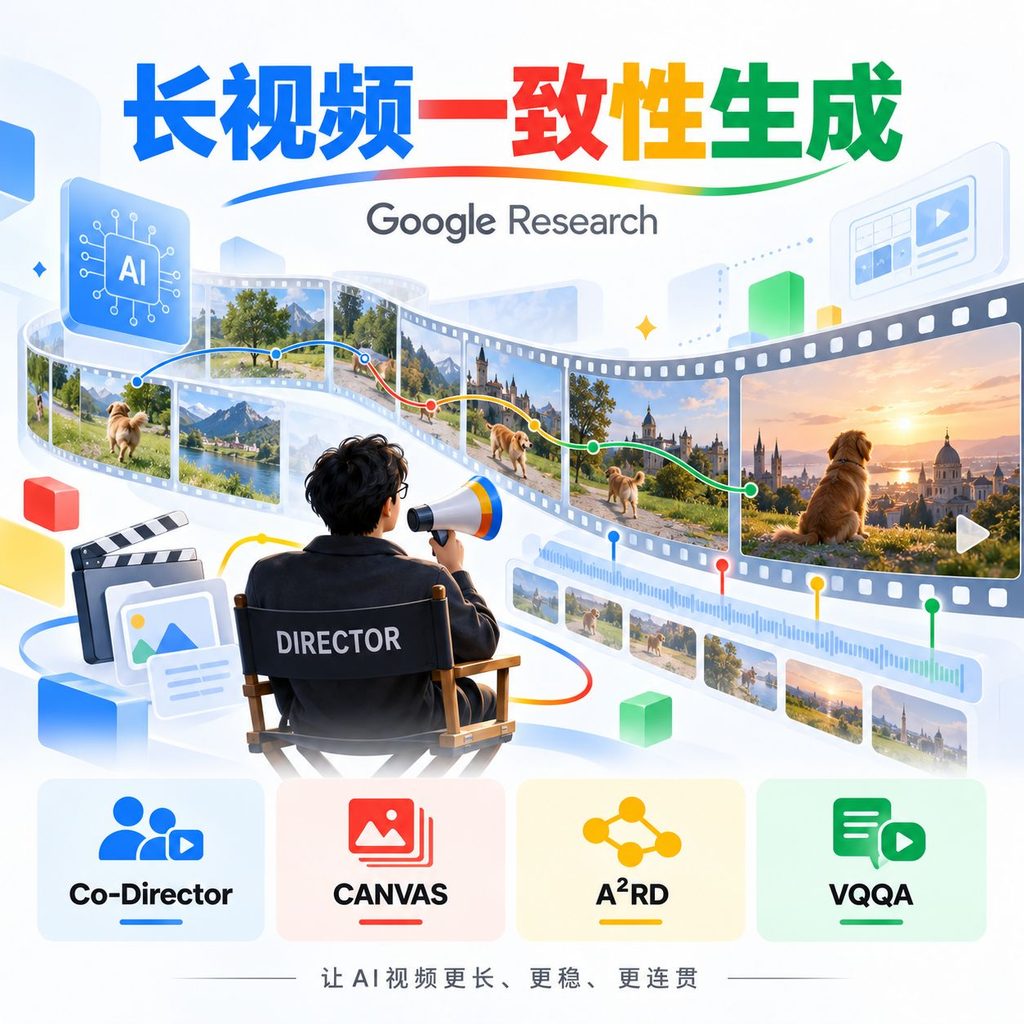
2026 年 9 月 24 日,Google Research 公布了一组围绕 Coherent Long-form Video Generation,即一致性长视频生成 的研究成果。它解决的重点并不是让单个视频片段变得更加逼真,而是一个长期困扰生成式视频的问题:怎样让几十个甚至上百个镜头组成的视频,在几分钟之后仍然保持人物、场景、物体和故事逻辑的一致。
这实际上标志着 AI 视频生成正在发生一次重要变化:从研究“如何生成视频”,逐渐转向研究“如何组织、管理和导演视频生成”。
一、为什么生成十分钟视频比生成十秒视频难得多?
Veo 等视频生成模型已经能够生成画质相当高的短视频,但如果把任务延长到几分钟,问题会迅速暴露出来。
例如,第一幕中的男主角穿着黑色外套,几十个镜头之后再次出现时可能变成灰色外套;一个房间最初有两扇窗户,再次回到这个场景时布局却发生变化;人物拿走桌上的钥匙后,后面的镜头里钥匙可能重新出现在桌上。
Google 将这类问题归纳为 语义漂移、特征漂移、内容坍塌以及级联错误。更麻烦的是,传统 AI 视频工作流通常采用线性流水线:
剧本 → 分镜 → 图片 → 视频 → 音频 → 剪辑。
如果前面某一步发生错误,错误会一路传递下去,而最终视频出现问题时,又很难知道究竟是哪一步造成的。这实际上类似机器学习中的“信用分配问题”:最后结果不好,但很难找到应该修改哪个环节。
因此 Google 的思路不是单纯制造一个“上下文更长的视频模型”,而是把整个视频生成过程变成一个 多智能体协作系统。
二、Co-Director:让 AI 出现一个“总导演”
整个体系最上层是 Co-Director。
Google 将视频制作看成一个全局优化问题,而不是简单地连续执行 Prompt。系统首先由 Orchestrator Agent,也就是“导演智能体”,决定创意策略、叙事模式和视觉风格,然后再把任务分配给前期制作、关键帧、视频、音频等不同智能体。
视频完成后,一个多模态大模型充当“评审”,重新观看成片,对结果进行评价,再把评价反馈给系统,重新调整创作策略。
这里一个很有意思的设计是引入 Multi-Armed Bandit,多臂老虎机算法。系统并不是永远按照一套固定创作流程工作,而是在多种创意路线之间不断尝试:哪些叙事结构更合适?哪些视觉风格效果更好?哪些组合值得继续强化?
所以它更像一个不断“试拍—审片—修改”的 AI 导演团队。
Google 在 GenAD-Bench 等测试中报告称,Co-Director 在多镜头内容质量和一致性方面优于已有基线方法。
三、CANVAS:给生成式视频建立一个“世界模型”
如果说 Co-Director 管的是整个创作过程,那么 CANVAS 管的则是故事世界。
它维护一套持续存在的视觉记忆,其中记录人物长什么样、穿什么衣服,场景是什么结构,道具在哪里,以及这些东西随着剧情发生了什么变化。
因此,当故事在十几个镜头之后重新回到某个房间时,系统不是重新根据文字“猜”这个房间应该是什么样,而是从视觉记忆中提取之前的场景锚点。
这种方法实际上非常接近游戏中的 World State——世界状态。
CANVAS 在论文中的测试显示,相比表现最好的基线系统,背景连续性提高约 21.6%,人物一致性提高 9.6%,道具一致性提高 7.6%。
这可能是整个研究最值得关注的思想之一:未来生成式视频系统需要的,不只是更大的视频模型,还需要一个能够持续记录“这个虚拟世界现在是什么状态”的记忆系统。
四、A²RD:真正把视频延伸到分钟级
有了故事板和世界状态,还需要把大量短片段连续生成出来。
Google 为此提出 A²RD——Agentic Autoregressive Diffusion。
它不是一次生成完整长视频,而是分段生成,每生成一段,就执行一次:
检索记忆 → 生成 → 检查 → 修正 → 更新记忆。
更关键的是,系统会根据情况在两种模式间切换。
当剧情需要向前发展时,它采用类似“外推”的方式,让故事产生新的动作和场景;当老人物、老场景重新出现时,则更多使用“插值式”约束,把画面重新锚定到之前保存的视觉信息。
这解决了长视频生成中的一个核心矛盾:
既不能完全复制过去,否则故事无法向前发展;也不能每次自由生成,否则人物和世界会逐渐变样。
Google 展示了最长约 10 分钟的连续生成结果。A²RD 论文报告,在一分钟至十分钟的视频测试中,相对于现有基线方法,一致性指标最高提升约 30%,叙事连贯性最高提升约 20%。
五、VQQA:让 AI 自己找视频里的错误
最后一块是 VQQA——Video Quality Question Answering。
传统视频生成通常是“生成完就结束”,而 VQQA 会主动针对视频提出问题。例如:
人物手里的物体是否正确?
服装是否发生变化?
不同镜头中的乐器是否属于同一个人?
然后由视觉语言模型回答这些问题,并把发现的问题转换成自然语言反馈,用来修改下一轮生成 Prompt。
Google 把这种反馈称为一种 “语义梯度”——它不像传统神经网络那样计算数学梯度,而是用语言告诉生成系统“应该往哪个方向改”。
因此形成:
生成 → 检查 → 提问 → 修改 Prompt → 再生成
的闭环。
论文数据显示,VQQA 相比直接生成,在 T2V-CompBench 上取得约 11.57 个百分点的绝对提升,在 VBench2 上提高约 8.43 个百分点。
从“视频模型”走向“AI制片系统”
这项研究真正值得关注的地方,并不是 Google 已经可以生成十分钟视频——更重要的是它展示了一种新的技术路线。
过去行业竞争主要集中在 Veo、Sora 等基础视频生成模型:分辨率多高、运动是否自然、一次能够生成多少秒。
而 Google 这组研究开始把问题向上一层移动:
模型负责拍镜头,Agent 负责拍电影。
Co-Director 负责全局创意和调度,CANVAS 负责世界状态和视觉记忆,A²RD 负责长时间轴生成,VQQA 负责质量检查和自动纠错。Gemini 与 Veo 则成为底层执行模型。Google 还强调,这套架构原则上并不绑定某一个基础视频模型,而是一层位于模型之上的 orchestration layer,即“编排层”。
当然,这距离真正自动生成高质量电影仍然很远。论文中的一致性提升主要建立在特定 benchmark 和实验环境上;生成分钟级内容所需要的大量模型调用、反复评估和重新生成,也意味着较高的计算成本。此外,“人物长得一样”和“故事真正好看”仍然是两个完全不同的问题。
但技术方向已经非常清晰。
AI 视频下一阶段的核心竞争力,可能不再只是单个生成模型有多强,而是谁能够构建更强的“导演智能体 + 世界模型 + 长期记忆 + 生成模型 + 自动评审”的完整系统。
从这个意义上说,Google 此次研究并不是简单地把 AI 视频从 10 秒延长到 10 分钟,而是在尝试把生成式视频从一个 内容生成模型,升级成一个真正意义上的 Agentic Video Production System——智能体视频制作系统。