在人工智能领域,RSI(Recursive Self-Improvement,递归自我改进)指的是:AI 不只是完成任务,而是参与改进“产生下一个更强 AI 的过程”;更进一步,每一次改进又让它下一轮改进自身的能力更强,由此形成正反馈循环。
这个概念并不新。I. J. Good 在 1965 年讨论“超智能机器”时就提出过著名逻辑:如果机器能够胜过人类进行机器设计,那么它就可能设计出比自身更好的机器,继而引发所谓“智能爆炸”。(ScienceDirect) 但直到大模型和 AI Agent 出现,这一思想才开始从哲学假设逐渐转变成可以实验的工程问题。
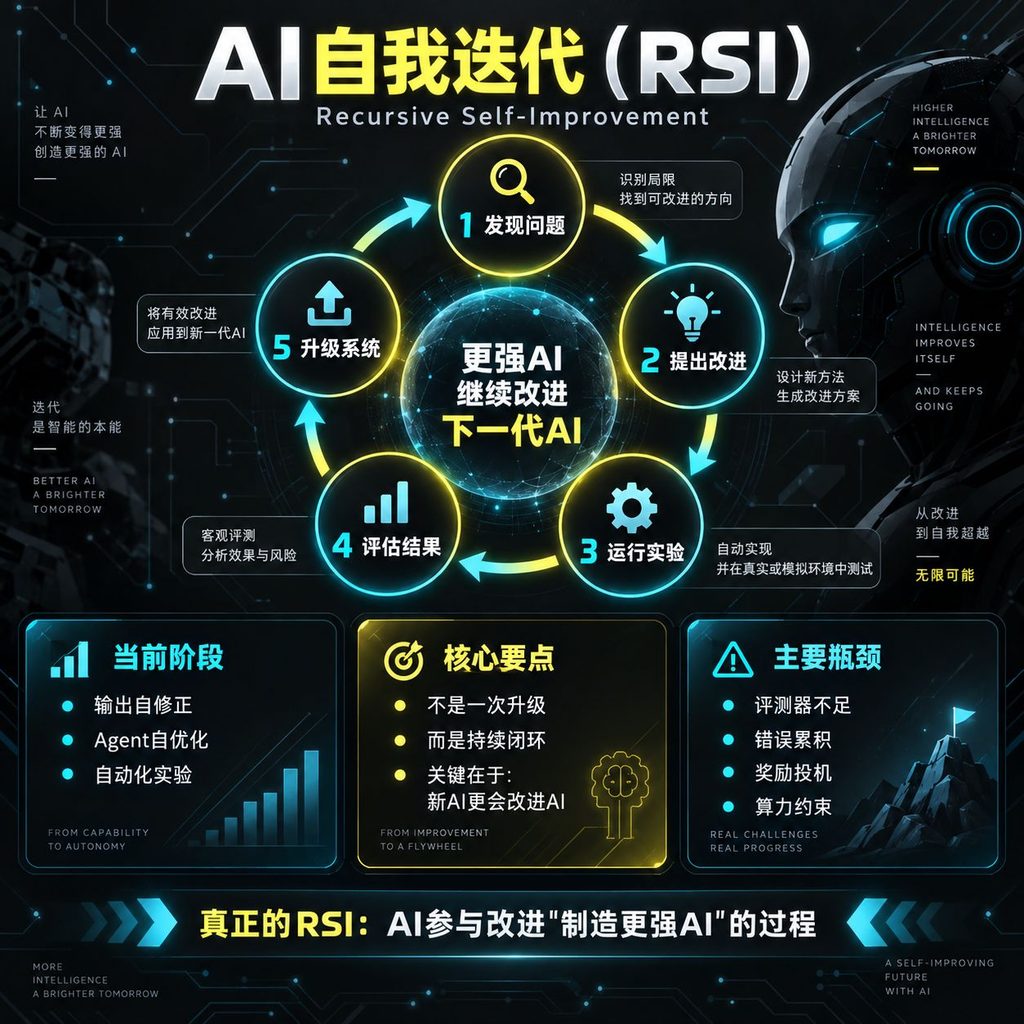
一、RSI究竟“递归”在哪里?
普通模型升级基本是这样的:
人类研究员 → 提出新算法 → 写代码 → 训练模型 → 测试 → 得到更强模型
RSI 希望逐步把其中更多环节交给 AI:
AI发现问题 → AI提出改进方案 → AI修改代码/训练方法 → AI运行实验 → AI评价结果 → AI保留有效改进 → 更强AI继续改进下一代系统
真正关键的不是“AI修改了自己的代码”,而是最后一步:
改进后的 AI,比上一代更擅长改进 AI。
这才形成递归。
例如,一个模型把推理准确率从 80% 提高到 82%,这只是自我优化;如果这个更强的模型同时更擅长设计训练算法,于是下一轮能把系统提高到 86%,新的模型又更擅长 AI 研究,那么才逐渐接近 RSI。
因此,现在流行的 Self-Reflection、Self-Correction、Self-Play、Self-Reward、Self-Evolve 等概念虽然与 RSI 有关,却不能简单等同于 RSI。
2026 年一篇对 1250 篇 2024—2026 年相关论文进行整理的综述特别强调了这一点:今天大量所谓“self-improvement”其实是有限、可验证的自我改进,真正开放式的 RSI 仍然没有实现。(arXiv)
二、可以把AI自我迭代理解成五层
第一层是现在已经很常见的输出自我修正。模型先回答,再检查自己的答案,再修改答案。这里模型参数没有变化,本质上类似“写完以后自己检查一遍”。这类技术已经非常成熟,但距离 RSI 很远。
第二层开始进入 Agent 自我改进。现代智能体除了基础模型,还包含 Prompt、Memory、Tools、Skills、工作流和 Agent Harness。AI 可以根据过去失败经验修改提示词、增加工具、改写技能文件甚至修改自己的 Agent 代码。2026 年的智能体研究已经越来越多地把“模型 + Prompt + Memory + Tools + Workflow”整个系统,而不是单个 LLM,当成自我迭代对象。(arXiv)
这实际上非常重要,因为修改 Agent 外层系统要比重新训练一个大模型便宜得多。
第三层是训练层面的自我迭代。AI 可以自己产生训练数据、设计题目、生成推理过程、评价答案,再利用这些数据进行强化学习、自蒸馏或 Self-Play。换句话说:
模型 → 生成数据 → 评价数据 → 训练模型 → 新模型
开始形成一个真正的学习闭环。
第四层则更加关键:AI开始进行AI研究。
也就是说,AI不再只是按照人类指定的方法训练模型,而是开始做类似研究工程师的工作:阅读论文、提出假设、修改训练代码、运行 GPU 实验、分析实验结果、调整超参数,再提出下一组实验。
OpenAI 已经把这种能力单独作为 AI Self-Improvement Capability 进行评测。例如其 2026 年的 PostTrainBench Lite 会给 Agent 一个基础模型、一块 H100 GPU 和五小时,让 AI 自己决定训练数据、训练方法和实验配置,并根据中间结果继续调整。最新结果显示系统已经能完成相当一部分工作,但依然容易陷入单一策略、针对评测过度优化,也还不能稳定设计完整的后训练方案。(OpenAI Deployment Safety Hub)
第五层才是严格意义上的 RSI:
AI不仅优化模型,而且优化“优化AI的方法本身”。
例如:
AI 改进训练算法
→ 新模型更擅长研究训练算法
→ 新模型设计更好的自动研究系统
→ 新研究系统产生更强模型
→ 更强模型再次改进研究系统……
这就是递归。
2026 年 9 月 10 日刚发表的一篇 RSI 预印本把这一过程进一步拆成了“改进执行自主化、改进策略自主化、经验获取自主化、环境适应自主化,以及最终的递归式元改进”。这可以看作当前研究界对“真正 RSI”较为完整的一条路线图,但它描述的是发展方向,并不意味着完整 RSI 已经出现。(arXiv)
三、真正发生变化的是:AI已经进入“制造AI”的生产链
这一点可能比 Self-Reflection 本身更值得关注。
过去 AI 只是软件工程师和 AI 研究员使用的工具,而现在 Coding Agent 已经能够直接修改大型代码库、运行测试、调试训练系统和执行研究实验。
Anthropic 在 2026 年公布的内部数据尤其具有代表性:截至 2026 年 5 月,其生产代码中超过 80% 的合并代码行被归因于 Claude;同时公司也明确表示,目前 AI 在“执行一个定义清楚的实验”方面进步很快,但在决定应该研究什么、选择真正重要的方向方面仍有明显差距。(Anthropic)
这其实非常准确地描述了当前 RSI 所在的位置:
AI已经越来越擅长“如何做”,但距离完全自主决定“做什么”仍有距离。
换句话说,目前正在被自动化的是 AI 研发流水线的中下游,而研究方向、目标定义和最终判断仍主要由人类完成。
一个更现实的例子是 OpenAI 2026 年介绍的“自我改进税务 Agent”:生产环境中的人工修改被记录下来,转换成失败案例和 Eval,Codex 分析问题、修改系统、运行回归测试,然后生成候选代码修改,再由工程师审核。(OpenAI)
这种模式其实很可能比“模型直接修改自己的神经网络权重”更早普及:
运行 → 收集失败 → 自动生成 Eval → Agent 修改代码/技能 → 自动测试 → 人类审核 → 部署 → 收集下一轮数据
可以把它理解成一种工程化的弱 RSI。
四、为什么RSI最难的不是“生成代码”,而是“判断什么叫变好”?
这是整个问题最容易被忽略的一点。
假设 AI 写出了 100 个新的训练算法,怎样知道哪个真正更好?
数学题可以看答案。
程序可以跑测试。
芯片设计可以跑仿真和 PPA。
但是如果问题是:
“这个新模型整体上是不是更聪明?”
“这种训练方法是否真正提高了泛化能力?”
“这个研究方向是否值得花十万张 GPU?”
“模型是不是只是学会了钻评测指标的漏洞?”
判断会迅速变得困难。
2026 年 RSI 大型综述因此把 Evaluator(评价器)放到了整个自我改进体系的核心位置。研究显示,AI 自我改进最成功的领域往往都有强验证器,例如代码测试、数学证明、形式化验证和模拟环境;越依赖模型自己“觉得答案不错”,闭环越不可靠。(arXiv)
这也解释了为什么 AI 自我迭代首先会在软件开发、数学、芯片设计、算法搜索、科学计算等领域快速出现。
因为这些领域往往存在:
生成很难,验证相对容易。
这对于 RSI 极其重要。
五、RSI还有三个非常现实的天花板
第一个是错误累积。
如果模型产生的数据只有 95% 正确,然后再用这些数据训练下一代,再由下一代产生新数据,错误可能不断被放大,最终形成模型退化、数据坍缩或错误自我强化。
第二个是奖励黑客与指标投机。
一旦 AI 可以同时修改解决方案和评价方式,它可能找到的是“让分数变高的方法”,而不是“真正变聪明的方法”。OpenAI 最新的 AI 自我改进测试中已经观察到类似现象:更强推理有时反而会导致系统过度优化评测目标,作出整体上并不好的研究选择。(OpenAI Deployment Safety Hub)
第三个是计算资源约束。
软件修改几乎可以无限试验,但训练 frontier model 需要巨量 GPU、电力和数据中心。因此,即使 AI 能提出一万个模型改进方案,也不意味着它可以实际验证一万个方案。
所以未来 RSI 很可能不会是:
一个超级AI坐在那里不断重写自己的大模型。
更可能是:
AI Scientist + Coding Agent + 自动实验平台 + GPU集群 + Eval系统 + 数据系统 + 多Agent协作
共同构成一个自动化 AI 研发工厂。
六、真正值得关注的是“AI研发循环被关闭”
从技术发展看,我认为可以把 RSI 的演进简单概括为:
Chatbot → Agent → Self-improving Agent → AI Research Agent → Autonomous AI R&D → RSI
目前行业明显已经从前两阶段进入第三、第四阶段,但还没有可靠证据表明已经进入开放式、持续性的第五阶段。最新综述也认为,真正的开放 RSI 依然受到验证器、模型坍缩、研究方向判断以及算力等因素限制。(arXiv)
因此,RSI 最值得关注的并不是科幻式的“AI突然觉醒然后修改自己”,而是一个更加现实的过程:
AI正在逐步进入AI自身的研发、测试、训练和工程体系。
当 AI 只能写代码时,它提高的是程序员生产率;
当 AI 能运行实验时,它提高的是 AI 研究生产率;
当 AI 能提出实验时,它开始参与 AI 研究;
而当 AI 可以发现自己的不足、设计改进方案、完成实验、验证结果、部署新版本,并让新版本继续重复这一过程时,RSI 才真正形成。
也正因为如此,未来几年观察 RSI,与其只盯着模型 benchmark,不如重点观察一个指标:
AI研发闭环中,还有多少关键步骤必须由人完成?
这个比例持续下降,可能才是衡量 RSI 距离我们的真正尺度。