继大语言模型、视觉基础模型之后,时间序列基础模型(Time-Series Foundation Models,TSFM)正在成为人工智能发展的又一个重要方向。
2026年10月15日,法国人工智能公司 Mistral AI 正式发布 Timestral 1.0,这是该公司推出的首个时序基础模型系列。其最大版本仅有2.09亿参数,却在GIFT-Eval、TIME和fev-bench三项主要公开预测基准上取得了领先成绩。
而在此前的8月31日,Google Research发布了TimesFM-3,将原有的单变量预测模型升级为能够联合分析多个变量、利用外部信息的通用预测系统。
与此同时,Amazon、Salesforce、Datadog、IBM、Nixtla等企业也在持续推进相关技术。
这场竞争的核心目标,是让AI不仅能够理解语言和图像,还能够从大量历史数据中学习随时间变化的规律,进而预测未来。
一、什么是时间序列基础模型?
时间序列(Time Series)是按照时间先后顺序排列的一组数据。
例如,工业设备每秒采集的温度、压力、振动和电流数据,电网每小时的用电量,商店每天的商品销量,以及数据中心持续变化的CPU利用率,都是典型的时间序列。
传统预测方法包括ARIMA、指数平滑,以及近年来广泛应用的LSTM、Transformer等深度学习模型。
这些方法可以取得很好的预测效果,但通常需要针对具体数据集建立模型、训练参数,并进行调优。
时序基础模型改变了这一思路。
它先利用跨行业、跨场景的大规模时序数据进行预训练,学习趋势、周期、波动及变量关联等通用规律,然后将这些能力迁移到新的预测任务中。
例如,一个经过充分预训练的时序基础模型,即使没有见过某台水泵的运行记录,也可能根据最近几天的振动、温度和压力数据,直接给出未来运行状态的预测。
这种无需针对新数据集重新训练的能力,称为零样本预测(Zero-Shot Forecasting)。
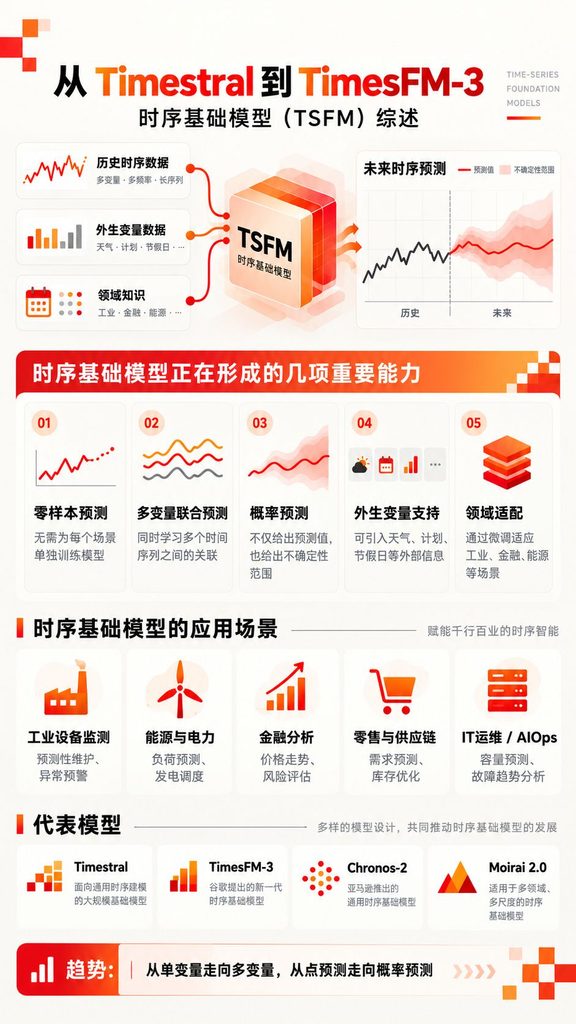
时序基础模型正在形成几项重要能力:
- 零样本预测: 不必为每台设备、每个产品单独训练模型。
- 多变量联合预测: 同时学习多个时间序列之间的关联。
- 概率预测: 不仅预测一个数值,还估计未来可能出现的范围。
- 外生变量支持: 在预测中引入天气、生产计划、节假日等外部信息。
- 领域适配: 通过微调,使通用模型适应特定行业。
这些能力使时序预测开始由传统的单任务建模,转向可复用的基础模型体系。
二、Mistral Timestral:用更小的模型实现高水平预测
Timestral是2026年10月时序基础模型领域最值得关注的新发布之一。
Mistral提供了四种不同规模的模型:
| 模型 | 参数量 | 主要定位 |
|---|---|---|
| Timestral-5M | 500万 | 轻量化、低延迟预测 |
| Timestral-28M | 2800万 | 计算效率与精度兼顾 |
| Timestral-123M | 1.23亿 | 高精度通用预测 |
| Timestral-209M | 2.09亿 | 系列最高预测精度 |
整个系列采用相同的架构和训练路线,主要通过模型规模调整性能与计算成本之间的平衡。
1. 长时间序列和多变量联合建模
Timestral支持最多32768个历史时间步长,并能够同时处理多个目标变量。
假设某台工业设备存在三条监测曲线:振动、温度和压力。
传统单变量预测可能分别判断三条曲线的未来变化。而Timestral可以同时学习三者之间的关系。
例如,当设备负载提高时,电流可能先上升,随后温度逐渐升高,振动也可能随之变化。
联合建模能够让模型利用这种关联,而不是孤立地分析每个传感器。
此外,Timestral还支持两类外部变量。
第一类是仅有历史数据的变量,例如过去测得的环境温度。
第二类是未来已经知道的变量,例如未来的生产排程、计划停机时间或节假日安排。
这一区分非常重要。因为设备发生变化,未必意味着出现故障,也可能是正常的工况切换。
如果模型提前知道未来生产负载将提高,就可以相应调整预测结果,减少不必要的异常报警。
2. 概率预测,而不只是预测一个数值
Timestral能够针对每个未来时间点输出21个分位数,覆盖从1%到99%的不同概率位置。
例如,预测某设备未来一小时的温度,模型可能给出:
- 中位数预测:65℃
- 10%分位数:62℃
- 90%分位数:69℃
这意味着,在模型的预测分布中,未来温度存在一个可能变化的范围,而不是只有65℃这一种结果。
对于工业应用,概率预测往往比单点预测更有价值。
设备监控系统可以依据预测区间判断异常程度,维护人员也可以根据超过安全阈值的风险制定检修计划。
不过,预测区间只有在实际数据上经过校准,才能可靠地反映真实风险。
3. 合成数据优先的训练方式
Timestral另一个突出特点,是其预训练数据主要由合成时间序列组成。
Mistral先生成具有趋势、季节性和不同噪声特征的单变量序列,再通过多变量合成方法,在不同序列之间引入非线性依赖关系。
这种方法的优势在于,可以主动构造大量不同的动态规律,而不完全依赖公开数据集。
训练分为两个阶段:
第一阶段使用纯合成数据,训练上下文长度为8192。
第二阶段混合真实数据与合成数据,并将上下文扩展到32768。
其目的在于同时提高模型的通用性,以及对真实世界复杂时间序列的适应能力。
但合成数据并非万能。真实工业设备中的突发故障、传感器漂移、复杂物理约束和罕见运行状态,未必能够被充分模拟。
4. 新的预测架构:DHF
Timestral采用基于Transformer的架构,并引入Decoupled Horizon Forecasting(DHF,解耦预测区间机制)。
这一机制将历史序列编码与未来预测位置分离。
通俗地说,模型首先完整理解已经观察到的历史数据,然后让专门的预测Token读取历史信息,生成未来结果。
相比将未来待预测位置直接混入历史序列进行掩码训练的方式,DHF可以更加明确地区分真实缺失值与需要预测的未来数据,也有助于充分利用已观测的信息。
Timestral还设计了协变量感知注意力机制,使模型能够读取已知的未来外部变量,同时避免看到未来真实目标值,防止预测中的信息泄漏。
5. 轻量化部署优势
Mistral公布的测试显示,在一台使用8个CPU线程的服务器上,以三周、15分钟采样间隔的历史数据预测未来一天:
Timestral-5M的推理延迟约为10毫秒,Timestral-209M约为140毫秒。
这些数据来自特定测试条件,不代表所有设备或批量预测任务的延迟。
但它说明,高水平的时序基础模型并不一定需要GPU才能推理。
对工业计算机、设备监测系统和企业内部数据平台来说,这是一个重要优势。
三、Google TimesFM-3:从单变量预测走向原生多变量预测
Google Research于2024年推出第一代TimesFM,随后发布TimesFM 2.0、2.5,并于2026年8月推出TimesFM-3。
最新的TimesFM-3拥有约3.3亿参数,预训练数据包含超过1万亿个时间点,覆盖真实和合成时间序列。
其最重要的变化,是从过去以单变量预测为主,升级为原生多变量预测模型。
1. TimesFM-3的技术特点
TimesFM-3同样采用Transformer架构,将连续时间序列划分为每32个时间步长一组的Patch。
但它采用了两类交替执行的注意力机制:
时间注意力(Temporal Attention) 用于学习同一个变量在不同时间点之间的依赖关系。
变量注意力(Variate Attention) 用于学习不同变量在同一时间范围内的相互关系。
例如,预测一家工厂未来的用电量,模型既需要理解历史用电周期,也需要考虑不同车间的负载、生产计划等信息。
TimesFM-3还使用连续Patch掩码(Contiguous Patch Masking)机制,使未来预测区间可以并行生成,减少逐步预测带来的计算开销和误差积累。
它能够同时输出点预测和9个分位数预测值。
2. Timestral与TimesFM-3的直接比较
两者代表了当前时序基础模型非常接近的技术方向,但在规模、训练方法和产品定位上存在差异。
| 对比项目 | Timestral 1.0 | TimesFM-3 |
|---|---|---|
| 开发机构 | Mistral AI | Google Research |
| 最大主力模型参数 | 2.09亿 | 3.3亿 |
| 多变量联合预测 | 支持 | 支持 |
| 历史及未来已知协变量 | 支持 | 支持 |
| 概率输出 | 21个分位数 | 9个分位数 |
| 主要预测机制 | DHF预测Token | 连续Patch掩码 |
| 训练数据特点 | 合成数据优先 | 大规模真实与合成数据 |
| 本地使用授权 | Modified MIT | 3.0权重非商业许可 |
按照Mistral发布的同组评测结果:
| 测试指标 | Timestral-209M | TimesFM-3 |
|---|---|---|
| GIFT-Eval MASE,越低越好 | 0.658 | 0.667 |
| GIFT-Eval CRPS,越低越好 | 0.446 | 0.456 |
| TIME MASE,越低越好 | 0.626 | 0.640 |
| TIME CRPS,越低越好 | 0.522 | 0.536 |
| fev-bench SQL技能评分,越高越好 | 50.39 | 48.99 |
从这些数据来看,Timestral-209M使用约少37%的参数,在上述测试中取得了更好的成绩。
不过必须指出,这些比较数据来自Mistral发布的模型卡及其评测结果,不能等同于已经获得全面独立验证。
截至此次发布,Timestral的完整技术报告仍待公开。
另外,Google TimesFM-3的一个商业部署限制也值得关注:其公开下载的3.0模型权重采用非商业许可证,不允许直接用于商业生产环境;但通过获得授权的Google Cloud服务,例如BigQuery ML,可以用于商业场景。
相比之下,Timestral权重采用Modified MIT许可证,企业仍需核查具体许可条款。
因此,两者的比较不能只看预测精度,还应综合考虑授权方式、部署成本和企业使用条件。
四、除了Timestral和TimesFM,还有哪些主要模型?
时序基础模型已经形成一个相当活跃的技术生态。
1. Amazon Chronos-2:通用预测的重要代表
Amazon于2024年发布Chronos,最初采用类似语言模型的方式,将连续数值离散化为Token,再通过预训练模型学习预测规律。
后续的Chronos-Bolt通过Patch处理和直接多步预测,大幅降低了推理成本。
2025年10月发布的Chronos-2则进一步支持单变量、多变量和协变量预测。
Chronos-2拥有约1.2亿参数,是目前通用时序预测的重要开源基线之一。
按照Mistral发布的比较,Timestral-28M在GIFT-Eval和TIME上的表现已经优于参数约为其4倍的Chronos-2。
这说明时序模型的预测性能,并不完全取决于参数规模。
2. Salesforce Moirai 2.0:通用时序建模
Salesforce AI Research在2025年8月发布Moirai 2.0。
它将此前的掩码编码器架构改为Decoder-only Transformer,并采用分位数损失和多Token预测方式,提高计算效率和预测能力。
Moirai系列的一项重要贡献,不只是模型本身,还包括相关训练与评测生态建设。
Salesforce推动的GIFT-Eval,已经成为当前评价时序基础模型泛化能力的重要基准之一。
3. Datadog Toto 2.0:强调规模扩展能力
Datadog在2026年推出Toto 2.0,其模型规模覆盖400万到25亿参数。
Toto 2.0采用交替时间注意力和变量注意力,并使用概率预测机制。
它的重要研究发现是:在所测试的规模范围内,增加参数通常能够持续改善预测性能。
这一结果为时序基础模型的规模扩展规律提供了新证据。
值得注意的是,Toto 2.0虽然支持多变量预测,但目前公开的2.0版本尚未原生提供与Timestral相同的完整外生变量支持和微调能力;相关功能仍在完善。
4. IBM Granite TinyTimeMixer:面向资源受限设备
IBM采取了另一条路线:尽可能缩小模型规模。
其TinyTimeMixer(TTM)系列从百万参数级起步,较新的Granite-TTM-R3覆盖约100万至3500万参数的模型配置。
该系列侧重低推理成本、快速预测、多变量处理和少样本适配。
对于工业现场的工控机、网关和计算资源有限的设备,这类小型模型具有实际吸引力。
但模型轻量并不自动意味着适合所有实时任务,还需要验证具体硬件上的内存占用、延迟以及预测效果。
5. NXAI TiRex-2:面向流式数据的循环架构
NXAI的TiRex系列基于xLSTM相关技术路线。
2026年推出的TiRex-2已支持多变量联合预测,以及历史和未来已知协变量。
其单变量模式激活约3840万参数,多变量模式还需额外激活约4410万参数。
与Transformer路线不同,TiRex-2强调循环架构及流式预测能力。
这使其在持续接收传感器数据、不断更新预测结果的工业系统中具有研究和部署价值。
6. 其他值得关注的模型
此外,还有几条值得关注的技术路线。
Nixtla TimeGPT 2.1 更重视企业服务化,支持多变量预测、外生变量、微调和企业环境部署。
蚂蚁国际 Falcon-TST 包括基于ORBIT训练机制的Falcon-2.0,以及面向异构多变量预测的Falcon-X。
Sundial 由清华大学相关研究团队推出,采用TimeFlow Loss,通过学习连续数值序列的生成分布实现概率预测,代表了生成式时序基础模型的一条路线。
总体而言,行业正在形成三种不同的发展重点:追求通用预测精度、追求轻量化和部署效率,以及强调生成式概率建模与企业集成。
五、主流时序基础模型的技术路线比较
综合上述模型,可以对主要技术方向进行归纳。
| 模型系列 | 主要技术特色 | 适合关注的场景 |
|---|---|---|
| Timestral | 合成预训练、DHF、多变量与概率预测 | 工业预测、边缘部署 |
| TimesFM-3 | 大规模预训练、原生多变量、并行预测 | 大规模企业预测 |
| Chronos-2 | 通用零样本预测、协变量支持 | 通用预测基线 |
| Moirai 2.0 | Decoder-only、通用建模 | 研究、模型适配 |
| Toto 2.0 | 大跨度模型规模、可扩展性 | 监控指标、高容量预测 |
| Granite TTM-R3 | 超轻量Mixer架构 | 边缘设备、批量推理 |
| TiRex-2 | 循环架构、流式数据处理 | 连续监测、工业数据 |
| TimeGPT 2.1 | 企业级服务、微调和部署 | 企业预测平台 |
需要特别说明的是,这张表描述的是各模型的主要特点,并非经过统一测试得出的性能排名。
六、如何评价模型性能?不能只看排行榜
目前行业主要使用GIFT-Eval、TIME和fev-bench等公开基准评价预测模型。
GIFT-Eval覆盖多种行业、时间频率和预测长度,重点考察模型的跨领域泛化能力。
TIME强调较新的评测数据,以降低预训练数据与测试数据重叠带来的影响。
fev-bench涵盖大量真实预测任务,既考察预测精度,也涉及不同变量和业务条件下的模型表现。
常见指标包括:
MASE(平均绝对比例误差):衡量模型相对于简单基准预测的误差水平,通常越低越好。
CRPS(连续分级概率评分):评价概率预测分布的质量,不仅考虑预测位置,还考虑不确定性的合理程度,越低越好。
但公开排行榜仍有局限。
首先,不同模型可能采用不同的训练数据和评测配置。
其次,部分模型在预训练时接触过与评测任务相关的数据,必须检查数据泄漏情况。
再次,综合平均成绩可能掩盖不同行业之间的巨大差异。
一个在零售需求预测中表现优秀的模型,不一定适合毫秒级机械振动数据。
2026年ICML相关研究也特别提出,时序基础模型需要更明确的领域级基准,以避免综合评分掩盖实际应用差异。
因此,排行榜适合用于初步筛选模型,但不能替代实际业务数据上的测试。
七、工业应用:从预测数值到预测设备风险
时间序列基础模型在工业AI领域具有很大的发展空间。
当前,大量工业监测系统采用固定阈值报警,或者根据历史故障样本训练专用分类模型。
前者难以适应复杂工况,后者往往受限于故障样本数量。
时序基础模型提供了一种新的思路:先预测正常运行趋势,再根据真实观测值与预测分布之间的差异判断潜在风险。
例如,对一套机电设备,可以同时输入电流、振动、温度以及运行状态等数据。
模型持续预测未来一段时间的传感器变化。当实际信号持续偏离正常预测区间时,系统可以生成异常候选事件。
这种方案特别适合与现有监测系统结合。
但必须区分三个层次。
第一层是预测。 判断未来信号可能如何变化,这是Timestral、TimesFM等模型最直接的能力。
第二层是异常检测。 根据预测误差、预测区间、残差变化等因素,识别值得关注的异常行为。
第三层是故障诊断。 判断异常究竟来自机械磨损、传感器故障、电气问题,还是工况切换。
后两个层次通常需要额外的判定算法、业务知识以及故障数据,不能认为一个通用预测模型已经自动解决了完整的故障诊断问题。
尤其对于高频振动、冲击等信号,通用时序模型可能无法直接捕捉关键的短时频谱特征。
实际工程中,可以先提取RMS、频谱能量、峰值或其他统计特征,再使用时序基础模型预测这些特征的变化。
对于安全要求较高的工业设备,还需要通过独立验证和保护机制,确保预测模型的错误不会直接造成危险控制动作。
八、下一阶段:时序基础模型与AI智能体融合
未来的工业AI系统,可能不再只有一个独立的预测模型。
更合理的架构,是由时序基础模型、异常检测模块、领域知识系统和AI智能体组成协同系统。
例如,时序模型发现某设备的振动趋势偏离正常范围。
异常检测模块确认这一偏离具有统计意义。
随后,AI智能体调取设备维护记录、运行日志、历史故障案例和技术手册,对可能原因进行分析。
最终,系统不只是报告“振动异常”,还可以形成一份包含异常证据、可能原因和建议检查项目的维护报告。
Mistral在Timestral发布说明中,也明确提出了将数值预测模型与语言模型及智能体结合的系统架构。
这代表了一个值得关注的方向:
时序基础模型负责理解数据如何随时间变化,语言模型和智能体负责联系业务知识、组织分析流程并生成可执行建议。
不过,这仍是一种需要工程验证的系统方案,而不是单个时序模型已经具备的全部能力。
九、结语:时序基础模型正在从研究走向实用
从Google TimesFM-3到Mistral Timestral,再到Amazon Chronos-2、Datadog Toto 2.0和IBM Granite TTM,时序基础模型的发展已经呈现出几项清晰趋势。
首先,单变量预测正在向原生多变量预测演进,模型开始同时理解多个传感器或业务指标之间的关联。
其次,概率预测逐渐成为重要能力,使预测结果能够直接服务于风险评估和决策。
第三,模型不再一味追求规模。Timestral和Granite TTM等模型说明,架构与训练方法的优化同样可以带来高效率。
第四,时序基础模型正在向工业现场、企业数据平台和AI智能体工作流延伸。
当然,时序基础模型仍不能完全取代经典统计方法、专用预测网络和基于物理机理的工程模型。
对于简单周期信号,传统方法可能更加可靠;对于高度专业化的数据,经过充分训练的领域模型仍可能更有优势。
真正有价值的发展方向,不是让一个模型替代所有算法,而是将通用预测能力与领域模型、物理知识和业务流程结合起来。
如果说大语言模型的突破在于让AI能够理解和生成语言,那么时序基础模型的重要意义,就是让AI开始具备跨场景学习动态规律、预测未来变化的通用能力。
对于工业AI而言,这种能力可能成为下一代设备监测、预测性维护和自主运行系统的重要技术基础。
参考资料
以下资料截至2026年10月16日,优先采用开发机构官方发布内容、模型仓库及研究论文。
- Mistral AI — Introducing Timestral(2026)https://mistral.ai/news/timestral/
- Mistral AI — Timestral 1.0 Model Documentationhttps://docs.mistral.ai/models/timestral-1-0
- Mistral AI — Timestral-209M Model Card and Benchmark Resultshttps://huggingface.co/mistralai/Timestral-209M
- Mistral AI — Timestral Official Repositoryhttps://github.com/mistralai/timestral
- Google Research — TimesFM-3: A Zero-Shot Foundation Model for Multivariate Forecasting(2026)https://research.google/blog/timesfm-3-a-zero-shot-foundation-model-for-multivariate-forecasting/
- Google Research — TimesFM Official Repositoryhttps://github.com/google-research/timesfm
- Amazon Science — Chronos: Pretrained Models for Time Series Forecastinghttps://github.com/amazon-science/chronos-forecasting
- Salesforce AI Research — Introducing Moirai 2.0(2025)https://www.salesforce.com/blog/moirai-2-0/
- Datadog — Toto 2.0: Time Series Forecasting Enters the Scaling Era(2026)https://www.datadoghq.com/blog/ai/toto-2/
- IBM Granite — Granite-TTM-R3 Model Cardhttps://huggingface.co/ibm-granite/granite-timeseries-ttm-r3
- NXAI — TiRex-2: Generalizing TiRex to Multivariate Data and Streaminghttps://github.com/NX-AI/tirex-2
- Nixtla — TimeGPT 2.1: The Next Generation of Foundation Models for Time Series Forecastinghttps://www.nixtla.io/blog/timegpt-2-1-announcement
- Ant International — Falcon-TST Official Repositoryhttps://github.com/ant-intl/Falcon-TST
- Liu et al. — Sundial: A Family of Highly Capable Time Series Foundation Models(ICML 2025)https://proceedings.mlr.press/v267/liu25be.html
- Salesforce AI Research — GIFT-Eval: A Benchmark for General Time Series Forecasting Model Evaluationhttps://github.com/SalesforceAIResearch/gift-eval
- Syed et al. — Position: Time-Series Foundation Models Require Explicit Domain-Level Benchmarks(ICML 2026)https://proceedings.mlr.press/v306/syed26a.html