截至 2026 年 10 月 6 日,光子 AI 芯片正在经历一个非常关键的阶段变化。
过去,人们讨论光计算,往往集中在一个问题上:光能不能比电子更快、更省电地完成矩阵乘法?
现在,问题已经明显改变。
2025—2026 年,一系列科研成果开始证明,光子芯片不仅能够进行高速矩阵计算,还逐步能够运行 ResNet、BERT、LLM、扩散模型等真正的 AI 工作负载;能够在芯片上进行反向传播训练;能够直接依据真实光子器件的物理状态进行“原位学习”;甚至开始拥有短期和长期记忆。
与此同时,产业界的发展方向更加明确:首先大规模商业化的很可能不是完全取代 GPU 的“光子 GPU”,而是光互连、Optical I/O、CPO,以及电子与光子组成的异构 AI 系统。
2026 年 9 月《Nature Photonics》发表的最新 Perspective 也指出,光子 AI 加速器正在能效、吞吐量、计算密度和延迟等指标上不断缩小与先进数字 AI 芯片的差距,而云端通用光子加速器和边缘专用光计算系统可能形成不同的发展路线。
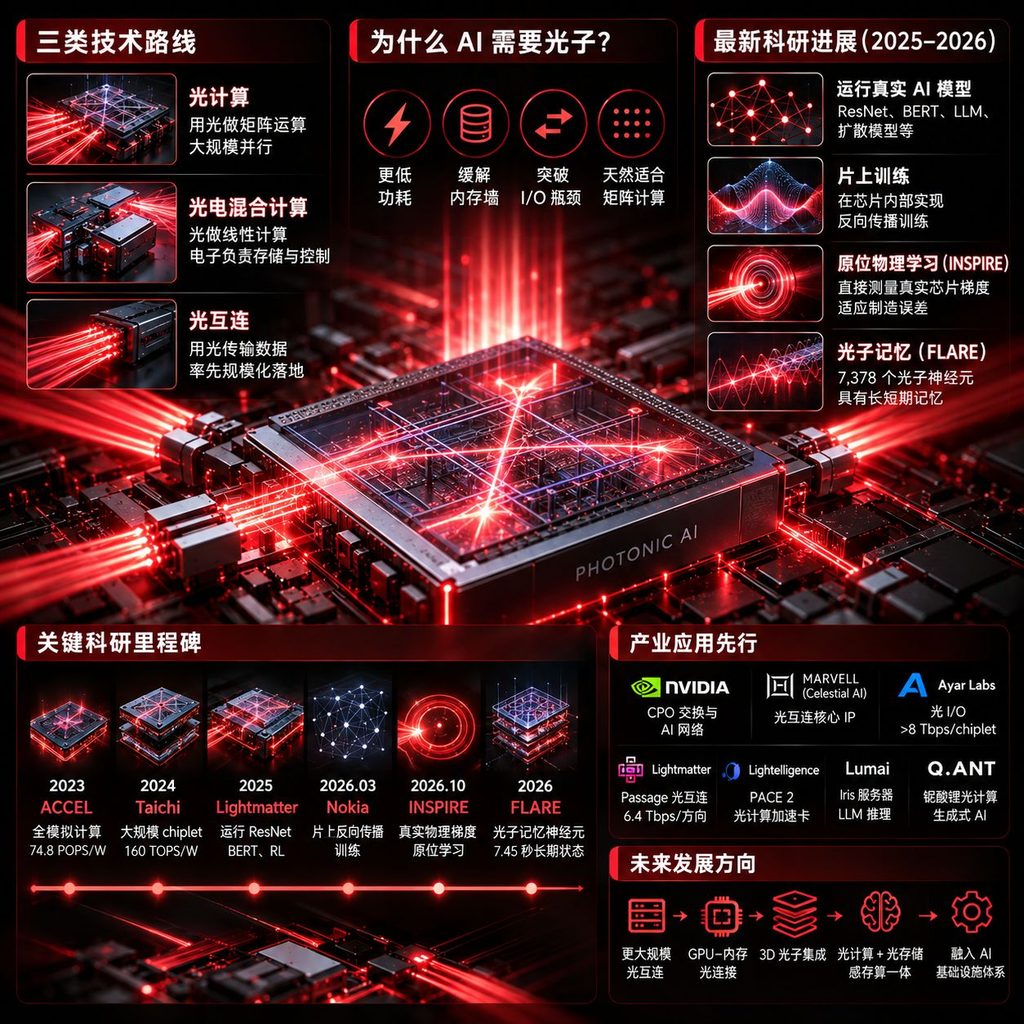
一、首先要分清:光子 AI 芯片其实有三条路线
今天所谓“光子 AI”,实际上至少包含三个不同层次。
第一类是 Photonic Computing——直接用光计算。
神经网络最核心的工作之一是矩阵—向量乘法。传统 GPU 需要大量晶体管不断执行乘法和加法,而光子芯片可以利用干涉、衍射、相位、振幅、波长等物理属性,在光传播过程中直接完成矩阵变换。
Mach-Zehnder Interferometer、微环谐振器、衍射结构等,都可以成为“光学乘法器”的组成部分。
第二类是 光电混合计算。
这是目前更现实的路线:
光负责大规模线性运算,电子负责存储、控制、非线性运算、数字接口以及精确计算。
Lightmatter、Lightelligence、Lumai、Q.ANT 等公司的产品,本质上都属于不同形式的光电异构计算,而不是完全抛弃 CMOS。
第三类是 Photonic Interconnect / Optical I/O——光互连。
它并不负责运行神经网络本身,而是解决:
GPU ↔ GPU、GPU ↔ HBM/DRAM、chiplet ↔ chiplet、服务器 ↔ 服务器之间的数据搬运。
恰恰是这一方向,目前距离大规模产业化最近。
因此,现阶段可以简单概括为:
短期看光互连,中期看光电混合计算,长期才看更完整的光子计算体系。
二、为什么 AI 恰好把光子技术推到了临界点?
AI 系统今天面对的已经不仅是“算力不够”。
实际上同时存在三堵墙:
计算功耗墙、内存墙和 I/O 墙。
尤其是大模型。
GPU 内部 Tensor Core 的矩阵计算已经非常快,但模型参数、激活值、KV Cache、梯度等数据需要不断在 HBM、GPU 和其他计算节点之间移动。
越来越多的功耗,不是消耗在“乘法”本身,而是在:
搬数据。
光在这里有几个天然优势。
首先是大规模并行。
一根光纤或波导可以通过 WDM 同时传输多个不同波长。空间、偏振甚至相位,也可以形成额外的并行计算维度。
其次是高速与距离优势。
高速电互连距离增加后,损耗、均衡和功耗迅速恶化,而光纤更加适合机架间乃至更长距离的高速数据交换。
第三是光学与线性代数天然匹配。
光的干涉和衍射过程本身就是数学意义上的线性变换,因此某些矩阵计算不一定需要通过大量数字乘法器逐项执行。
但光也存在明显弱点:
难存储、难实现精确数字逻辑、非线性运算困难。
所以未来真正有竞争力的架构,很可能不是“全光 GPU”,而是:
电子负责记忆、控制和精确数字逻辑,光负责大规模矩阵运算和高速数据移动。
三、科研重心已经变了:不再只是证明“光能算”
过去光子神经网络研究的一个典型问题是:
很多论文最终还是停留在 MNIST 之类的小型实验任务上。
所以即使某个实验系统能够达到极高的 TOPS/W,也很难证明它能够进入真实 AI 工作负载。
但是从 2023 年开始,这种情况发生了明显变化。
| 时间 | 代表成果 | 主要意义 |
|---|---|---|
| 2023 | ACCEL | 光电全模拟视觉计算,尝试绕开大规模 ADC |
| 2024 | Taichi | 光子 chiplet 扩展到千类别识别和 AIGC |
| 2025 | Lightmatter | 运行 ResNet、BERT、深度强化学习 |
| 2026 | Nokia Bell Labs | 芯片内部实现反向传播训练 |
| 2026 | Photonic MoE | 把 MoE 的“扩宽”思想引入光子神经网络 |
| 2026 | 3D PNN | 用三维光子结构突破二维布线和密度限制 |
| 2026 | FLARE | 把计算、感知以及长短期记忆结合起来 |
| 2026.10 | INSPIRE | 让真实光子芯片直接测量梯度并进行原位学习 |
ACCEL 在 2023 年展示了 4.6 POPS 计算速度和 74.8 POPS/W 系统能效,其中超过 99% 的运算由光学完成,并通过光电全模拟架构减少大规模 ADC 带来的开销。
2024 年的 Taichi 则进一步利用光子 chiplet 和衍射—干涉混合架构,将规模推进到百万级神经元能力,并报告 160 TOPS/W 能效,在实验中实现千类别级识别和 AI 生成内容任务。
这意味着问题已经从:
“光能不能做神经网络?”
逐渐变成:
“光子芯片能不能运行真实 AI、能不能训练、能不能适应制造误差、能不能拥有状态和记忆、最后能不能规模化?”
四、Lightmatter:从“光能算”推进到“真正 AI 模型能运行”
2025 年发表于《Nature》的 Universal photonic artificial intelligence acceleration 是一个重要节点。
Lightmatter 团队展示了一套光子 AI 处理器,不再只运行简单分类网络,而是进一步运行了 ResNet、BERT 以及 Atari 深度强化学习模型。
这项工作的意义并不只是速度。
更重要的是:
精度。
光计算属于模拟计算,因此会受到:
相位误差、激光噪声、热漂移、制造误差以及器件非理想性等影响。
此前很多光学计算器理论性能很高,但一旦运行大型深度学习模型,误差可能逐层累积。
因此,这项工作的真正意义是:
光子处理器开始从“证明可以做矩阵乘法”,进入“能够执行现实 AI 模型”的阶段。
这也是光计算迈向实用化必须跨过的一道门槛。
五、2026 年第一次重要跨越:让光子芯片自己完成反向传播
下一道障碍是:
训练。
传统光子神经网络往往采用这样的流程:
训练在 GPU 上完成 → 得到权重 → 把权重配置到光子芯片 → 光子芯片只负责推理。
问题在于,软件中的“理想光子芯片”和真正制造出来的芯片并不完全相同。
2026 年 3 月,Nokia Bell Labs 在《Nature》发表 Integrated photonic neural network with on-chip backpropagation training。
研究人员把梯度反向传播真正推进到集成光子神经网络内部,实现了包括线性计算、非线性激活以及梯度相关过程在内的片上训练。
这是一个重要变化:
过去是:
GPU 训练 → 光子芯片执行。
现在开始变成:
光子芯片自己参与训练。
换句话说,光子 AI 芯片开始从单纯的“高速推理协处理器”,朝着真正的可训练计算介质演进。
六、2026 年 10 月的最新突破:真实芯片直接“原位学习”
但片上训练之后,还存在一个更深的问题。
即使训练算法运行在光子系统附近,人们往往仍然需要一个相对准确的数字物理模型:
软件必须知道每个光学器件大约是什么状态,然后计算梯度。
可是现实芯片存在大量难以完全建模的因素:
制造误差、热漂移、器件老化、耦合误差、光学散射等。
因此真正理想的方式是:
不要试图完全模拟真实芯片,而是直接问真实芯片:“你的梯度是多少?”
2026 年 10 月 5 日,《Nature Computational Science》发表:
Photonic neuromorphic learning via generalized in situ physical gradient descent
清华大学等团队提出了 INSPIRE——in situ physical gradient descent,即原位物理梯度下降。
其关键思想是利用片上合成时间反演全息,直接测量光子系统中双向传播模式的完整复光场。
有了真实物理系统内部的光场信息,就可以直接计算:
参数应该往哪个方向调整。
也就是说,梯度不再主要来自一个模拟模型,而是直接来自真实芯片本身。
实验训练出的矩阵相对误差达到约 0.26%。更重要的是,该方法具有较强的 topology-agnostic——拓扑无关性,并不仅仅适用于某一种固定 MZI 网络。
研究人员甚至利用散射介质训练出了规模大于原生可调单元数量的矩阵。
进一步,他们又将 INSPIRE 用于 in situ meta-learning——原位元学习,报告实现 251 倍模型压缩以及 136 倍任务特定训练加速。
这一成果的意义很值得强调。
Nokia Bell Labs 的突破主要解决:
“光子神经网络能不能在芯片上进行反向传播?”
INSPIRE 进一步问:
“能不能不依赖一个完美的数字芯片模型,而让真实光子芯片直接根据自己的物理状态学习?”
答案开始变成:
可以。
这意味着光子计算研究开始从 Photonic Computing 向 Physical Learning——物理学习推进。
可以把目前的演进简单理解为:
软件训练 → 硬件推理
↓
光子芯片参与训练
↓
直接测量物理梯度
↓
芯片根据自己的真实物理状态进行原位学习
这是光子 AI 近几年非常重要的一条技术主线。
七、不只是训练:光子神经网络还在解决“规模”和“记忆”
另一个问题是:
AI 模型越来越大,但光子网络不能简单无限增加深度。
因为光路越深:
损耗越大、误差越容易累积、控制复杂度也越高。
2026 年的 Photonic Mixture-of-Experts 工作提出了一条很有意思的路径:
不一定继续加深,而是加宽。
研究人员在单片芯片中部署多个光学 Expert,根据任务动态路由到不同光子网络。实验芯片包含 3 个协同光学专家网络和 18 个并行 kernel,在多领域图像分类中实现平均 97.1% 的准确率,同时减少约 67% 数字参数开销。
这实际上把数字大模型中的 MoE 思想第一次比较完整地移植到了片上光计算。
另外一个方向则是三维光子集成。
因为二维芯片上的波导交叉、面积和 I/O 数量都会成为瓶颈,研究人员开始利用 3D Photonic Neural Network,把光路扩展到垂直维度,从而提升光计算密度和连接能力。
未来的大规模光计算,很可能不会只是:
更大的二维光学矩阵。
而会逐渐转向:
光子 chiplet + 3D photonics + 多计算核心。
八、光子计算开始拥有“记忆”
这是另一个非常关键的变化。
光最大的优点之一是:
跑得快。
但它最大的缺点也是:
跑得太快,很难留下来。
电子芯片可以利用 SRAM、DRAM、Flash 等保存状态,而传统光子系统天然缺乏类似能力。
2026 年 8 月,清华团队在 Nature Sensors 发表 Fully in-memory photonic computing,提出 FLARE 架构。
研究团队把光、电以及光电机制结合,在一颗单片芯片中实现 7,378 个具有记忆能力的光子神经元。
这些光子神经元同时具有:
GHz 级短期动态
以及
约 7.45 秒长期记忆。
研究团队进一步组成十核、多层系统,并用于自主竞速无人机导航和环境适应。
它的重要意义甚至可能超过单纯提高 TOPS。
因为未来 AI 芯片真正要解决的不只是:
“怎么算得快?”
而是:
“数据为什么要不断从存储器搬到计算单元,再从计算单元搬回存储器?”
如果光计算能够把:
Sensor + Memory + Compute
进一步融合,就有可能出现真正意义上的:
光子感存算一体。
九、科研已经走得很远,但产业首先爆发的是“光互连”
这里就出现了一个很有意思的科研—产业差异。
实验室最吸引眼球的是:
“光能不能直接做 AI 计算?”
产业界目前最愿意花钱解决的却是:
“怎样让成千上万颗 GPU 更高效地互相通信?”
2026 年最典型的例子来自 NVIDIA。
NVIDIA Vera Rubin 平台已经把 Spectrum-X Ethernet Photonics 纳入正式架构。
其交换系统采用 CPO,把光学引擎与交换 ASIC 更紧密地封装在一起,并使用 200 Gb/s SerDes。
NVIDIA 在 2026 年 5 月宣布 Spectrum-X Ethernet Photonics 已进入生产,并宣称其相比传统可插拔光收发器网络可以达到约 5 倍网络功耗效率。
这是一个很重要的产业信号:
Photonics 已经开始进入 AI Factory 的核心基础设施。
十、Marvell 收购 Celestial AI:光互连开始成为核心半导体资产
2026 年 2 月,Marvell 完成对 Celestial AI 的收购。
Celestial AI 的核心技术不是“用光代替 GPU 算矩阵”,而是:
Photonic Fabric。
它的目标是利用光连接大规模 AI 加速器,解决 scale-up 网络中的带宽和功耗问题。
这个事件非常具有代表性。
因为它说明传统半导体巨头已经开始把光互连视为:
下一代 AI 芯片系统中的核心 IP。
而不再只是一个外围通信器件。
十一、Lightmatter 的转向尤其值得注意
Lightmatter 最初因为光计算芯片受到关注。
但今天公司的商业重心明显越来越靠近:
Passage 光互连平台。
2026 年推出的 Passage L20 提供:
单方向 6.4 Tbps,也就是发送和接收各 6.4 Tbps。
同时采用双向波长复用,让同一根光纤承担两个方向的数据传输。
公司还在推动 1.6 Tbps/fiber 等更高密度光连接。
这条产品路线非常具有启示性:
先把光用于芯片之间,再逐渐把光推进芯片内部。
也就是说:
Interconnect → Optical I/O → Photonic Interposer → Photonic Compute
可能比直接制造一个“纯光 GPU”更加现实。
十二、Ayar Labs:专注 Optical I/O
Ayar Labs 的思路更加明确:
它基本不去重新设计一颗 GPU,而是专注于:
如何把 GPU/XPU 的电 I/O 变成光 I/O。
2026 年 9 月,公司宣布新增 1.5 亿美元融资,使 2026 年一级资本融资总额达到 6.5 亿美元。
AMD、Intel、MediaTek、NVIDIA 等都在其战略投资者和产业生态中。资金主要用于产品开发、验证、制造生态建设以及高产量生产准备。
这说明产业竞争已经从:
“光芯片能不能做出来?”
逐渐进入:
“能不能制造、封装、测试并大批量交付?”
十三、真正的“光 AI 计算产品”也开始出现
产业另一端,真正用光参与 AI 数学运算的系统也开始走出实验室。
Lightelligence
Lightelligence 的 PACE 2 已经做成 PCIe Gen4 x16 加速卡。
其核心包括:
128×128 可配置光学矩阵
8-bit 光计算输出精度
超过 40,000 个光子器件
以及
3D TSV 先进封装。
这条路线非常重要:
不是要求用户建立一台全新的“光计算机”,而是让光计算作为普通服务器中的一个异构加速器存在。
Lumai
2026 年 4 月,牛津大学孵化公司 Lumai 推出 Iris 光计算推理服务器系列。
其中 Iris Nova 已经能够运行 Llama 8B 和 Llama 70B。
其系统仍然是混合架构:
数字处理器负责软件与控制,Optical Tensor Engine 负责核心数学计算。
Lumai 宣称特定架构下能够实现最高约 90% 的能耗降低,不过这一指标目前仍主要来自企业自身披露,需要更多独立 benchmark 验证。
尤其值得注意的是:
Lumai 把重点放到了 LLM Prefill。
这是非常合理的。
因为 prefill 阶段具有大量密集矩阵运算,非常适合光学并行计算;而 decode 阶段则更多受到 KV Cache 和内存带宽制约。
Q.ANT
Q.ANT 则采用另一种材料体系:
Thin-Film Lithium Niobate on Insulator——薄膜铌酸锂。
与大量依赖热调制的硅光器件不同,铌酸锂可以通过电场改变光学特性,从而减少热串扰,并具有高速调制潜力。
其 Native Processing Server 已经做成标准 19 英寸服务器,内部配置 PCIe 光子 NPU。
2026 年 6 月,Q.ANT 又展示了在第二代 NPU 上运行:
扩散模型
以及
xLSTM 循环神经网络。
这意味着商业光子硬件正在从传统分类任务进入生成式 AI 和时间序列 AI 工作负载。
十四、下一个战场可能是 GPU 与内存之间
Photonics 的另一个重要方向正在出现:
GPU ↔ 内存。
Volantis 就是一个典型例子。
它不是制造光计算核心,而是试图利用 VCSEL 等光互连技术,把 GPU 与更多内存器件连接起来,从而突破电互连距离和封装规模限制。
这个思路背后的逻辑其实很简单:
今天 AI 面临的很多问题,不是 GPU 算不动,而是:
数据喂不进去。
所以未来光互连很可能从:
服务器 ↔ 服务器
逐渐进入:
GPU ↔ GPU
↓
Package ↔ Package
↓
Chiplet ↔ Chiplet
↓
GPU ↔ HBM / DRAM
甚至最终进入片内网络。
Intel 的 Optical Compute Interconnect(OCI) 就已经沿着这一方向发展。
Intel 第一代 OCI chiplet 支持 4 Tbps 双向连接,内部集成硅光 PIC、DWDM 激光器、光放大器以及 CMOS EIC,并计划向单器件数十 Tbps 演进。
十五、为什么不能看到“100 TOPS/W”就认为 GPU 要被淘汰?
这是理解光子 AI 最重要的问题之一。
论文中的光计算性能经常非常惊人。
原因是:
光完成一次矩阵变换,本身可能几乎不需要像数字晶体管那样不断开关。
但是完整光计算系统还有大量外围器件:
Laser
↓
DAC
↓
Modulator
↓
Photonic Matrix
↓
Photodetector
↓
TIA
↓
ADC
↓
Digital Memory / Control
真正的服务器能效,必须计算整条链。
如果只统计中间的 optical MAC,TOPS/W 会非常漂亮。
但如果把:
激光器、ADC/DAC、温控、PCIe、HBM、控制芯片和数据搬运
全部计算进去,优势往往会明显降低。
所以评价未来光子 AI 芯片,不能只看:
TOPS/W。
还应该看:
tokens/s
tokens/J
模型精度
端到端服务器功耗
ADC/DAC 功耗
光源功耗
内存和通信功耗
以及
实际计算利用率。
这也是为什么 ACCEL、FLARE、INSPIRE 等研究如此值得关注。
它们已经不再单纯追求:
“让中间那个光学矩阵更快。”
而是在解决完整系统中的:
AD 转换、训练、存储、器件误差和系统适应性。
十六、光子 AI 真正还缺什么?
目前剩下的核心问题已经比较清楚。
首先是精度与稳定性。
光子模拟计算天然受到热漂移、器件误差、激光噪声、工艺变化影响。
INSPIRE 这种原位物理学习的重要意义,就是尝试把这些“不完美”直接纳入学习过程。
第二是非线性。
矩阵乘法非常适合光,但 ReLU、Softmax、Normalization、逻辑控制等运算并不天然适合光。
因此至少在可预见的未来:
Optical + Electronic
仍然比纯光方案更加现实。
第三是存储。
大型模型最终需要大量参数和 KV Cache。
FLARE 已经展示光子记忆神经元,但距离 TB 级大模型参数存储仍然非常远。
第四是转换开销。
如果每次矩阵计算前后都必须进行:
Digital → Analog → Optical → Analog → Digital
那么外围转换器可能吃掉大量收益。
第五是软件生态。
CUDA 真正强大的地方不只是 GPU,而是围绕 GPU 建立的:
PyTorch、编译器、kernel library、runtime、调度工具以及开发者生态。
光子计算必须尽可能做到:
用户不需要懂光学。
这也是 PACE 2、Lumai Iris、Q.ANT NPS 都开始采用 PCIe、Python API、标准服务器形态的重要原因。
第六是封装与制造。
进入 CPO 时代以后,真正困难的问题包括:
PIC、ASIC、laser、fiber attach、thermal management、yield、repairability。
很多问题已经不再是“光学论文问题”,而是标准的:
半导体产业工程问题。
十七、未来真正的形态可能不是“光子 GPU”
综合目前科研与产业信息,我认为未来 5—10 年光子 AI 最可能出现的形态,并不是:
一颗光子芯片突然取代 NVIDIA GPU。
更可能是:
GPU / XPU + HBM + CMOS + Photonic Matrix Engine + Optical I/O + CPO + Optical Fabric
逐渐融合成一个新的异构 AI 计算系统。
其中哪些功能迁移到光域,将取决于光在哪些环节真正具有系统级优势。
大致演进顺序可能是:
数据中心光网络
↓
机架间光互连
↓
GPU 间 Optical I/O
↓
Package / Chiplet 光互连
↓
GPU—Memory 光连接
↓
部分矩阵计算光化
↓
片上训练
↓
原位物理学习
↓
光子存储与感存算一体
按照当前产业成熟度,可以粗略判断:
| 技术 | 2026 年成熟度 | 状态 |
|---|---|---|
| 数据中心传统光模块 | ★★★★★ | 大规模成熟 |
| CPO / Optical I/O | ★★★★☆ | 正进入规模部署 |
| GPU Scale-out 光网络 | ★★★★☆ | NVIDIA 等推进产业化 |
| Photonic Chiplet / Interposer | ★★★☆☆ | 快速发展 |
| 光学矩阵 AI 加速器 | ★★☆☆☆~★★★☆☆ | 已出现商业系统 |
| LLM 光计算推理 | ★★☆☆☆ | 开始进入评估阶段 |
| 光子片上训练 | ★★☆☆☆ | 实验验证 |
| 原位物理学习 | ★★☆☆☆ | 前沿科研突破 |
| 光子存算一体 | ★★☆☆☆ | 前沿科研阶段 |
| 全光通用 AI 处理器 | ★☆☆☆☆ | 长期目标 |
十八、最值得关注的变化:光子芯片开始从“计算器”变成“学习机器”
如果只看三年前,光子 AI 最重要的问题是:
光能不能高效做矩阵乘法?
今天这个问题已经越来越不是核心矛盾。
现在真正重要的是:
光计算能不能成为完整 AI 系统的一部分?
而过去两年的技术进展已经逐渐形成了一条很清晰的路径:
Lightmatter:真实 AI 模型能够运行
↓
Nokia Bell Labs:芯片能够反向传播训练
↓
INSPIRE:真实物理芯片能够直接获得梯度并原位学习
↓
FLARE:光子神经元开始具有记忆
这条路线比单纯刷新一个 TOPS/W 数字更加重要。
与此同时,产业端又形成另一条更加现实的路线:
光模块
↓
CPO
↓
Optical I/O
↓
Photonic Interposer
↓
GPU / Memory 光互连
↓
光电混合计算
两条路线最终很可能汇合。
所以,2026 年观察光子 AI,最值得关注的已经不是:
“光计算会不会替代 GPU?”
而是:
“AI 系统中究竟有多少计算、通信、存储和学习过程,会逐步迁移到光域?”
从 NVIDIA 的 CPO、Marvell 收购 Celestial AI,到 Ayar Labs、Lightmatter 的 Optical I/O,再到 Lightelligence、Lumai、Q.ANT 的光计算系统,以及 Nokia、FLARE 和最新 INSPIRE 的片上训练、记忆与原位学习,答案已经越来越清楚:
光子技术正在从 AI 系统外围的通信技术,逐渐深入 AI 计算架构内部。
它大概率不会取代电子计算。
真正可能发生的是:
电子与光子的边界不断向芯片内部移动。
而一旦光真正同时进入 Interconnect、Compute、Memory 和 Learning 四个层面,所谓“光子 AI 芯片”才会从一种特殊加速器,逐渐演化成一种新的 AI 计算体系结构。
参考资料
- Photonic accelerators for AI across cloud and edge platforms — Nature Photonics, 2026
Nature Photonics:Photonic accelerators for AI across cloud and edge platforms - All-analog photoelectronic chip for high-speed vision tasks — Nature, 2023
Nature:ACCEL 光电全模拟计算芯片 - Large-scale photonic chiplet Taichi empowers 160-TOPS/W artificial general intelligence — Science, 2024
PubMed:Taichi 光子 Chiplet - Universal photonic artificial intelligence acceleration — Nature, 2025
Nature:Universal photonic artificial intelligence acceleration - Integrated photonic neural network with on-chip backpropagation training — Nature, 2026
Nature:Integrated photonic neural network with on-chip backpropagation training - Photonic neuromorphic learning via generalized in situ physical gradient descent — Nature Computational Science, 2026
Nature Computational Science:INSPIRE 原位物理梯度下降 - Photonic Mixture-of-Experts for scalable multi-task on-chip optical neural networks — Nature Communications, 2026
Nature Communications:Photonic Mixture-of-Experts - Programmable Three-dimensional Photonic Neural Network Chip — Nature Communications, 2026
Nature Communications:3D Photonic Neural Network Chip - Fully in-memory photonic computing — Nature Sensors, 2026
Nature Sensors:Fully in-memory photonic computing / FLARE - NVIDIA Vera Rubin Ramps Into Full Production to Power Agentic AI Factories Worldwide — NVIDIA, 2026
NVIDIA:Vera Rubin 与 Spectrum-X Ethernet Photonics - Marvell Completes Acquisition of Celestial AI — Marvell, 2026
Marvell:完成收购 Celestial AI - Lightmatter Vision / Photonic Computing and Interconnect Roadmap — Lightmatter
Lightmatter:Photonic Computing 与 Interconnect 路线图 - Lightmatter Expands Photonic Interconnect Roadmap with Passage L20 Unified Optical Engine — Lightmatter, 2026
Lightmatter:Passage L20 - Industry Leaders Formally Launch CPO System Architecture Initiative within the Open Compute Project — Lightmatter, 2026
Lightmatter:Open Silicon Photonics for AI Systems - Ayar Labs Expands 2026 Funding to $650 Million to Scale Manufacturing-Ready CPO for AI Scale-Up Beyond the Rack — Ayar Labs, 2026
Ayar Labs:2026 年融资与 CPO 量产计划 - TeraPHY Optical I/O Engine — Ayar Labs
Ayar Labs:TeraPHY Optical I/O - PACE 2 Optoelectronic Accelerated Computing Card — Lightelligence
Lightelligence:PACE 2 光电计算加速卡 - Lumai Launches the World’s First Optical Computing System for Real-Time, Billion-Parameter LLM Inference — Lumai, 2026
Lumai:Iris 光计算 LLM 推理服务器 - The Photonic AI Accelerator / Native Processing Server — Q.ANT
Q.ANT:Native Processing Server 与光子 NPU - Q.ANT Runs Generative AI on Photonic Hardware — Q.ANT, 2026
Q.ANT:扩散模型和 xLSTM 运行于光子硬件 - Volantis raises $88 million for technology to connect AI memory chips — Reuters, 2026
Reuters:Volantis GPU—Memory 光互连 - Intel Silicon Photonics / Optical Compute Interconnect — Intel
Intel:Silicon Photonics 与 OCI - Intel Demonstrates First Fully Integrated Optical I/O Chiplet — Intel
Intel:4 Tbps Optical Compute Interconnect Chiplet